
-
-
-
التدريب والضبط الدقيق
-
تقييم الخبراء المُدار
-
-
خاصة
-
-
الشركة
لطالما دار نقاشٌ حول كيفية تأثير الذكاء الاصطناعي على جميع جوانب حياة الإنسان، ولا شك أنك أدركت الآن أنه يمتلك القدرة على أن يكون التقنية الأكثر تأثيرًا على الإطلاق. اليوم، يمكننا التحدث إلى سيري أو كورتانا أو جوجل للحصول على إجابات لاستفساراتنا الأساسية، لكن الكثير من إمكانياتها الحقيقية لا يزال مجهولًا.
يتطلب بناء ذكاء اصطناعي يفهم اللغة البشرية فهمًا حقيقيًا أكثر من مجرد بيانات خام، فهو يستلزم مجموعات بيانات تدريبية مصنفة بدقة، ومُقدمة من خبراء لغويين، وعلى نطاق واسع للمؤسسات. تُعدّ Shaip مزودًا رائدًا لخدمات معالجة اللغة الطبيعية، حيث تقدم خدمات وحلولًا شاملة لمعالجة اللغة الطبيعية لفرق الذكاء الاصطناعي حول العالم: بدءًا من جمع بيانات نصية وصوتية مخصصة، وصولًا إلى التعليق من قِبل خبراء، ومجموعات بيانات جاهزة لمعالجة اللغة الطبيعية، وتوفير كوادر متخصصة مُدارة بالكامل لأكثر من 150 لغة.
سواء كنت تُدرّب نظام ذكاء اصطناعي تفاعلي، أو تُحسّن نموذجًا لغويًا ضخمًا، أو تُنشئ مُحركًا لتحليل المشاعر، أو تُوسّع نطاق خط أنابيب التعرف على الكيانات المُسماة، فإنّ أكثر من 30 ألف مُتعاون مُعتمد لدى Shaip يُقدّمون بيانات تدريب معالجة اللغة الطبيعية (NLP) المُهيكلة وعالية الجودة التي تحتاجها نماذجك للأداء بدقة في العالم الحقيقي. تحظى حلول Shaip لمعالجة اللغة الطبيعية بثقة شركات Fortune 500 في قطاعات الرعاية الصحية والمالية والتكنولوجيا والتجزئة، حيث تجمع بين أدوات المنصة الخاصة وعمليات الجودة وفق منهجية 6 سيجما وخبراء المجال لتلبية متطلبات الدقة والإنتاجية للذكاء الاصطناعي المُستخدم في الإنتاج.

يبدأ كل نموذج لغوي عالي الأداء ببيانات تدريب مصممة خصيصًا لهذا المجال. توفر خدمات جمع بيانات معالجة اللغة الطبيعية من Shaip المدخلات الدقيقة التي يحتاجها نموذجك - بكميات كبيرة، وبلغتك، وبالتنوع اللغوي الذي يتطلبه النشر في العالم الحقيقي.
نُوفّر مجموعات نصوص مُخصصة وكبيرة الحجم عبر مختلف الصيغ: رسائل البريد الإلكتروني، ومراجعات العملاء، ومنشورات وسائل التواصل الاجتماعي، وتذاكر الدعم، والعقود القانونية، والوثائق المالية، وغيرها. تتوفر خدماتنا لجمع النصوص بأكثر من 150 لغة ولهجة محلية، وتُستخدم في تدريب روبوتات الدردشة، وتحسين برامج إدارة التعلم، وأنظمة البحث، وأنظمة فهم الوثائق.
من النصوص المكتوبة إلى الحوارات العفوية، يجمع Shaip تسجيلات صوتية عالية الجودة مصممة خصيصًا لتلبية متطلبات التعرف التلقائي على الكلام أو الذكاء الاصطناعي الصوتي، بما في ذلك اللهجات المختلفة، ومستويات الضوضاء المحيطة، والخصائص الديموغرافية للمتحدثين، وظروف القناة. يتم تسليمها كمجموعات مستقلة أو كحزم ASR كاملة مع نصوص مكتوبة، وقواميس نطق، ووثائق خاصة بكل لغة لتدريب النموذج فورًا. يتم تسليم جميع البيانات المجمعة مع بيانات وصفية كاملة، وتحديد هوية المتحدث، والتحقق من الجودة من خلال منصة Shaip الخاصة بالتعليقات التوضيحية.
تتطلب نماذج معالجة اللغة الطبيعية الدقيقة بيانات تدريب مشروحة بدقة. تجمع خدمات شرح البيانات من Shaip بين قوة عاملة متعددة اللغات ومؤهلة ومنصة خاصة لتقديم تصنيفات دقيقة باستمرار على نطاق المؤسسات، مع بوابات جودة مدمجة وتتبع تسليم شفاف.

تغطي قدراتنا في مجال التعليق على معالجة اللغة الطبيعية جميع أنواع المهام الرئيسية:
يتم تقديم جميع التعليقات التوضيحية من خلال عملية جودة ذات مراحل وبوابات 6 سيجما مع تسجيل اتفاق المعلقين وحلقات التغذية الراجعة المستمرة.

تصفح مجموعة البيانات الصوتية الخاصة بنا والتي تضم مجموعة متنوعة من مجموعات بيانات معالجة اللغة الطبيعية الجاهزة للاستخدام، والتي تحتوي على أكثر من 20,000 ساعة من الصوت، حول مجموعة متنوعة من المواضيع مثل مراكز الاتصال، والمحادثات العامة، والمناظرات، والخطابات، والمحادثات، والأفلام الوثائقية، والأحداث، والمحادثات العامة، والأفلام، والأخبار، وما إلى ذلك، بأكثر من 40 لغة.
نُقدّم لكم فريقاً من الخبراء المهرة يُصبح امتداداً لفريقكم، لدعم مهامّكم في تصنيف البيانات، باستخدام الأدوات التي تُفضّلونها مع الحفاظ على الجودة المطلوبة. يتمتّع فريقنا بخبرة واسعة وفهم دقيق للغات البشرية، ويُطبّق أفضل الممارسات المُكتسبة من خلال تصنيف ملايين الوثائق الصوتية والنصية، لتقديم حلول عالمية المستوى في مجال تصنيف البيانات لمعالجة اللغة الطبيعية.

بدءًا من جمع النصوص والملفات الصوتية وصولًا إلى إضافة التعليقات التوضيحية، نُقدّم فهمًا أعمق للغة المنطوقة من خلال نصوص وملفات صوتية مُفصّلة ومُصنّفة بدقة، ما يُحسّن أداء نماذج معالجة اللغة الطبيعية لديك. سواءً كنت تُدرّب مساعدًا افتراضيًا/رقميًا، أو ترغب في مراجعة عقد قانوني، أو بناء خوارزمية تحليل مالي، فإننا نُوفّر لك البيانات عالية الجودة التي تحتاجها لتطبيق نماذجك في الواقع العملي. يُتقن فريقنا اللغة واللهجات والنحو وبنية الجمل، ما يُتيح له تصنيف النصوص بدقة وفقًا لمتطلبات عملك.
نحن من بين الشركات القليلة المتخصصة في معالجة اللغات الطبيعية التي تفخر بقدراتها اللغوية المتميزة. لدينا فريق عالمي يضم أكثر من 30,000 متعاون من مختلف أنحاء العالم، يتمتعون بخبرة في أكثر من 150 لغة . لقد ساعدنا الشركات الناشئة في مراحلها الأولى، والشركات الصغيرة والمتوسطة، وعملنا مع كبرى شركات Fortune 500 في مختلف القطاعات ، مثل الرعاية الصحية، وتجارة التجزئة/التجارة الإلكترونية، والتمويل، والتكنولوجيا، وغيرها، لتحقيق أهداف مشاريعهم في مجال معالجة اللغات الطبيعية.
أكثر من 50 ألف ساعة من مجموعات بيانات الصوت / الكلام الجاهزة لمساعدتك على المضي قدمًا.
قم بتحليل المشاعر الإنسانية من خلال تفسير الفروق الدقيقة في تقييمات العملاء ووسائل التواصل الاجتماعي وما إلى ذلك.

اجمع مجموعات البيانات النصية ، مثل رسائل البريد الإلكتروني ، والرسائل القصيرة ، والمدونات ، والمستندات ، والأوراق البحثية ، إلخ.

يتطلب تدريب المساعدين الرقميين مجموعة كبيرة من البيانات عالية الجودة من مختلف المناطق الجغرافية واللغات واللهجات والإعدادات والتنسيقات. في Shaip ، نقدم بيانات التدريب لنماذج الذكاء الاصطناعي مع الإنسان في الحلقة الذين لديهم المعرفة المطلوبة وخبرة المجال ويدركون جيدًا الاحتياجات المحددة للعميل.
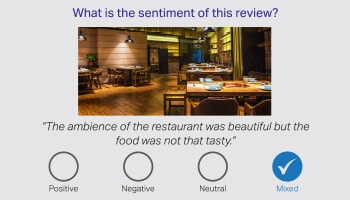
يقال بحق أن الكلمات وحدها تفشل في إيصال القصة بأكملها ، ويقع العبء على المعلقين البشر لتفسير الغموض في اللغة البشرية. ومن ثم فإن تحديد شعور العميل بناءً على المحادثة له أهمية قصوى. يمكن لخبراء اللغة لدينا من مختلف المجالات تفسير الفروق الدقيقة في مراجعات المنتجات والأخبار المالية ووسائل التواصل الاجتماعي.
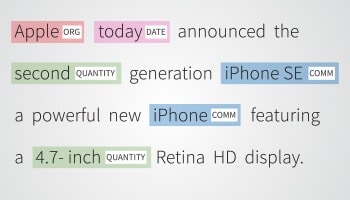
التعرف على الكيانات المسماة (NER) هو تحديد واستخراج وتصنيف الكيانات المسماة داخل نص ، إلى فئات محددة مسبقًا. يمكن تصنيف النص على أنه مكان ، اسم ، منظمة ، منتج ، كمية ، قيمة ، نسبة مئوية ، إلخ. باستخدام NER ، يمكنك معالجة أسئلة العالم الحقيقي مثل المنظمات التي تم ذكرها في المقالة وما إلى ذلك.
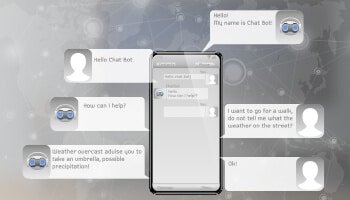
أحدثت روبوتات المحادثة الافتراضية أو المساعد الرقمي القوي والمدرب جيدًا ثورة في الطريقة التي يتواصل بها العملاء مع البائعين مما أدى إلى تحسن كبير في تجربة العملاء.
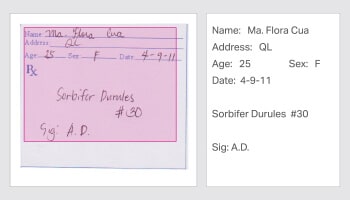
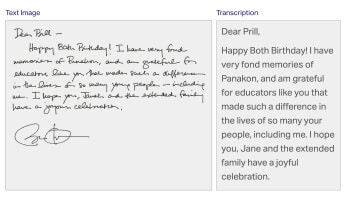
من الوصفات الطبية المكتوبة بخط اليد إلى ملاحظات المكالمات الجماعية ، يمكن لمتخصصينا رقمنة أي شكل من أشكال البيانات ، مثل المستندات المؤرشفة ، والعقود القانونية ، والسجلات الصحية للمرضى ، وما إلى ذلك.
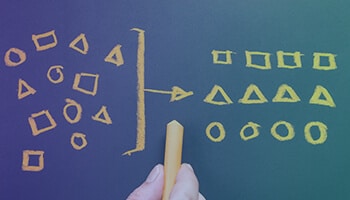
التصنيف المعروف أيضًا باسم التصنيف أو وضع العلامات هو عملية تصنيف النص إلى مجموعات منظمة ووضع علامات عليها ، بناءً على ميزاته المهمة.
التقييم البشري والتحرير اللاحق لمخرجات الترجمة الآلية لقياس الطلاقة والكفاءة ودقة المجال - مما يتيح أنظمة ترجمة آلية موثوقة لعمليات النشر متعددة اللغات.
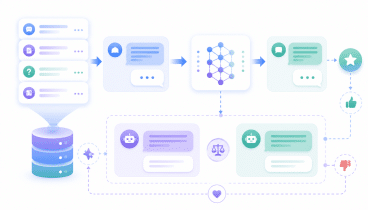
مجموعات بيانات مُنسقة لتتبع التعليمات، وأزواج الاستجابة للمطالبات، وبيانات تفضيل RLHF لضبط نماذج اللغة الكبيرة ومواءمتها مع متطلبات المجال والنبرة والمهمة الخاصة بك.
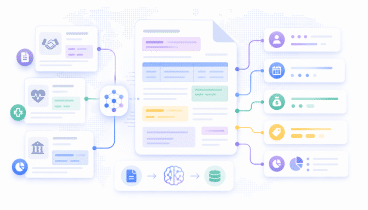
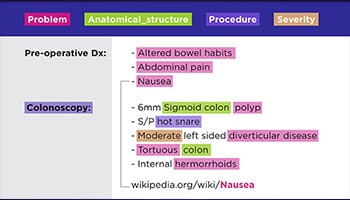
شرح هياكل المستندات المعقدة - العقود والسجلات الطبية والملفات المالية - لتدريب نماذج الذكاء الاصطناعي للمستندات التي تستخرج وتصنف وتستنتج النصوص غير المهيكلة على نطاق واسع.
تحليل الموضوع أو تصنيف الموضوع هو تحديد واستخلاص المعنى من نص معين عن طريق تحديد الموضوعات / الموضوعات المتكررة قيد الدراسة.
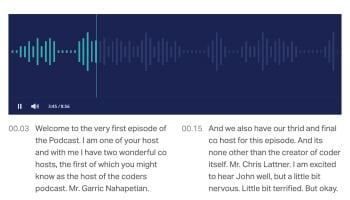
قم بنسخ الكلام / البودكاست / الندوة ، واتصل بالمحادثة إلى نص. الاستفادة من البشر في إضافة تعليقات توضيحية إلى ملفات الصوت / الكلام لتدريب نماذج البرمجة اللغوية العصبية بدقة.

تصنيف الأصوات أو الأقوال لتصنيف الكلام / الصوت بناءً على اللغة واللهجة والدلالات والمعاجم وما إلى ذلك.
يمكن لمجموعتنا من الخبراء المتمرسين في التعليقات التوضيحية النصية / الصوتية / وضع العلامات الحصول على مجموعات بيانات NLP دقيقة وفعالة.
يساعدك فريقنا في إعداد البيانات النصية / الصوتية لتدريب محركات الذكاء الاصطناعي ، مما يوفر وقتًا وموارد ثمينة.
يمكن لفريق المتعاونين لدينا استيعاب حجم إضافي مع الحفاظ على جودة إخراج البيانات لحلول البرمجة اللغوية العصبية الخاصة بك.
بصفتنا خبراء في تدريب الفرق وإدارتها ، فإننا نضمن تسليم المشاريع ضمن الميزانية المحددة.
يحلل الفريق البيانات من مصادر متعددة وهو قادر على إنتاج بيانات تدريب الذكاء الاصطناعي بكفاءة وبأحجام في جميع الصناعات.
يوفر النطاق الواسع لبيانات الصوت / النص للذكاء الاصطناعي كميات وفيرة من المعلومات اللازمة للتدريب بشكل أسرع.

فرق متخصصة ومدربة:

يتم ضمان أعلى كفاءة للعملية من خلال:

تقدم المنصة الحاصلة على براءة اختراع فوائد:
توفر روبوتات الدردشة بالذكاء الاصطناعي تجربة مستخدم محسنة من خلال التعلم من التفاعلات السابقة وفهم سلوك المستخدم وفهم اللغات المختلفة باستخدام مهارات صنع القرار المتقدمة.

قطعت ميزة التعرف التلقائي على الكلام (ASR) شوطًا طويلاً. على الرغم من أنه تم اختراعه منذ فترة طويلة ، إلا أنه نادرًا ما يستخدمه أي شخص. ومع ذلك ، فقد تغير الوقت والتكنولوجيا الآن بشكل كبير.

من المقرر أن يرتفع سوق معالجة اللغات الطبيعية العالمية من 1.8 مليار دولار في عام 2021 إلى 4.3 مليار دولار في عام 2026 ، بمعدل نمو سنوي مركب قدره 19.0٪ خلال هذه الفترة.
تمكين الفرق لبناء منتجات ذكاء اصطناعي رائدة عالميًا.


إن معالجة اللغة الطبيعية (NLP) هي فرع من الذكاء الاصطناعي الذي يمكّن الآلات من فهم اللغة البشرية، سواء كانت نصية أو كلامية، وتحليلها والاستجابة لها، من خلال تفسير السياق والمشاعر والقصد.
تتضمن معالجة اللغة الطبيعية (NLP) معالجة اللغة البشرية باستخدام خوارزميات تُحلل القواعد النحوية والنحوية والدلالية والسياق. وتعتمد على كميات هائلة من البيانات المُعلّقة لتدريب نماذج الذكاء الاصطناعي على استخلاص المعنى وتحديد الأنماط وتوليد استجابات دقيقة.
تُستخدم معالجة اللغة الطبيعية (NLP) في تطبيقات مثل المساعدين الافتراضيين، وروبوتات الدردشة، وتحليل المشاعر، والترجمة الآلية، وتلخيص النصوص، وكشف البريد العشوائي، وتصحيح القواعد النحوية. وهي تُشغّل أنظمة تجعل التفاعلات بين الإنسان والحاسوب أكثر كفاءةً وطبيعيةً.
تتضمن خدمات معالجة اللغة الطبيعية جمع النصوص (الحصول على بيانات نصية متنوعة)، وجمع الصوت (تسجيل بيانات الكلام)، وشرح البيانات (وضع علامات على النص والصوت لتدريب الذكاء الاصطناعي)، والنسخ (تحويل الكلام إلى نص للتحليل).
تُحسّن حلول معالجة اللغة الطبيعية (NLP) نماذج الذكاء الاصطناعي بتوفير مجموعات بيانات مُصنّفة بدقة تُساعد النماذج على فهم اللغة البشرية بشكل أفضل. يُحسّن هذا مهامًا مثل تحليل المشاعر، والتعرف على الكيانات المُسمّاة (NER)، والذكاء الاصطناعي المُحادثي، وتدريب روبوتات الدردشة.
وتشمل الصناعات الرئيسية الرعاية الصحية (تحليل السجلات الطبية ومعنويات المرضى)، والتمويل (الكشف عن الاحتيال وتحليل المستندات)، والتجارة الإلكترونية (التوصيات الشخصية وأتمتة دعم العملاء).
تختلف الجداول الزمنية وفقًا لحجم المشروع وتعقيده، ولكنها مُحسّنة لتقديم بيانات عالية الجودة بكفاءة.
يتم ضمان الجودة من خلال عمليات التحقق الصارمة، والمحللين الخبراء، والأدوات المتقدمة، مما يضمن أن البيانات تلبي أعلى المعايير.
تعتمد التكاليف على عوامل مثل نطاق المشروع، وتعقيد البيانات، واحتياجات التخصيص. تواصل مع Shaip للحصول على عرض سعر مُخصص يُناسب احتياجاتك.
يشير مصطلح "معالجة اللغة الطبيعية كخدمة" إلى نموذج تسليم بيانات مُدار بالكامل، حيث يتولى مزود خدمة معالجة اللغة الطبيعية جميع مراحل مسار بيانات اللغة نيابةً عنك، بدءًا من جمع البيانات وتصنيفها، مرورًا بضمان الجودة، وصولًا إلى تسليمها. تقدم Shaip نماذج تسليم قائمة على المشاريع، ونماذج اشتراك، ونماذج فرق عمل متكاملة، لتناسب مختلف احتياجات المؤسسات وأحجام المشاريع.
تتألف كل مجموعة لغوية من متحدثين أصليين أو شبه أصليين تم اختيارهم وفحصهم للتأكد من معرفتهم بالمجال. تتم معايرة التعليقات التوضيحية وفقًا لمجموعات مرجعية معيارية، وتضمن عملية جودة من ستة مراحل سيجما مع تسجيل اتفاق المعلقين الاتساق عبر جميع أزواج اللغات واللهجات.
تُدير شركة Shaip عمليات سير عمل متوافقة مع قانون HIPAA لمشاريع معالجة اللغة الطبيعية في مجال الرعاية الصحية، وتلتزم بمتطلبات إدارة الموافقة الخاصة باللائحة العامة لحماية البيانات (GDPR) فيما يتعلق بجمع البيانات في الاتحاد الأوروبي. تشمل جميع المشاريع توثيق مسار التدقيق، وسجلات مصدر البيانات، وضوابط الوصول القائمة على الأدوار لفرق الامتثال المؤسسي.
نعم. توفر Shaip مجموعات بيانات تتبع التعليمات، وأزواج الاستجابة، وبيانات تفضيل RLHF لضبط نماذج التعلم الموجه (LLM) ومواءمتها. تغطي صفحة حلول الذكاء الاصطناعي التوليدي لدينا النطاق الكامل لخدمات بيانات تدريب نماذج التعلم الموجه.
تتضمن عملية جمع البيانات الحصول على نصوص أو ملفات صوتية خام، وهي المواد التي سيتعلم منها النموذج. أما عملية إضافة التعليقات فتتضمن تصنيف هذه البيانات الخام باستخدام علامات أو فئات أو كيانات أو مؤشرات تحليلية منظمة، تُساعد النموذج على فهم ما يجب فهمه. تقدم Shaip كلا الخيارين كخدمات مستقلة أو كحل متكامل وشامل لمعالجة البيانات اللغوية الطبيعية.
نعم. لقد عمل شيب مع شركات ناشئة في مراحلها الأولى، وشركات صغيرة ومتوسطة، وشركات مدرجة ضمن قائمة فورتشن 500. نقدم نطاقًا مرنًا للمشاريع، وحزم بيانات أساسية قابلة للتطبيق لمشاريع الذكاء الاصطناعي في مرحلة المنتج الأولي، ونماذج تسليم قابلة للتطوير تتناسب مع احتياجاتك من البيانات. تواصل معنا للحصول على عرض سعر مخصص.

نحن نستخدم ملفات تعريف الارتباط لتحسين تجربتك على موقعنا. باستخدامك موقعنا، فإنك توافق على استخدام ملفات تعريف الارتباط.
قم بإدارة تفضيلات ملفات تعريف الارتباط الخاصة بك أدناه:
تعمل ملفات تعريف الارتباط الأساسية على تمكين الوظائف الأساسية وهي ضرورية للوظيفة المناسبة لموقع الويب.
يتيح لك Google Tag Manager تبسيط إدارة علامات التسويق على موقع الويب الخاص بك دون الحاجة إلى إجراء تغييرات على الكود.
تجمع ملفات تعريف الارتباط الإحصائية المعلومات بشكل مجهول. تساعدنا هذه المعلومات على فهم كيفية استخدام الزوار لموقعنا الإلكتروني.
Google Analytics هي أداة قوية تعمل على تتبع حركة المرور على موقع الويب وتحليلها لاتخاذ قرارات تسويقية مستنيرة.
رابط الخدمة: policies.google.com (يفتح في نافذة جديدة)
تُستخدم ملفات تعريف الارتباط التسويقية لمتابعة زوار المواقع الإلكترونية. والهدف هو عرض إعلانات مناسبة وجذابة للمستخدم.
إعلانات جوجل هي منصة إعلانية عبر الإنترنت تُمكّن الشركات من إنشاء إعلانات مستهدفة تُعرض على نتائج بحث جوجل ومواقع الشركاء.
رابط الخدمة: policies.google.com (يفتح في نافذة جديدة)
HubSpot عبارة عن منصة متكاملة للتسويق والمبيعات وخدمة العملاء تعمل على تبسيط نمو الأعمال.
رابط الخدمة: legal.hubspot.com (يفتح في نافذة جديدة)
يمكنك العثور على مزيد من المعلومات في سياسة ملفات تعريف الارتباط وسياسة الخصوصية الخاصة بنا.