بيانات التدريب والتعليقات التوضيحية لتقنية الذكاء الاصطناعي الفيزيائي
يقدم Shaip بيانات تدريب VLA وتعليقات VLA - من جمع البيانات الواقعية والبيانات التي يتم تشغيلها عن بعد إلى تصنيف مسار الحركة، وRLHF، والتقييم - بحيث تتعلم الروبوتات وأنظمة الذكاء الاصطناعي المادية الخاصة بك من مجموعات بيانات نظيفة وقائمة على العمل وذات جودة نشر عالية.
ما نقدمه
بيانات تدريب VLA، تم بناؤها من البداية إلى النهاية
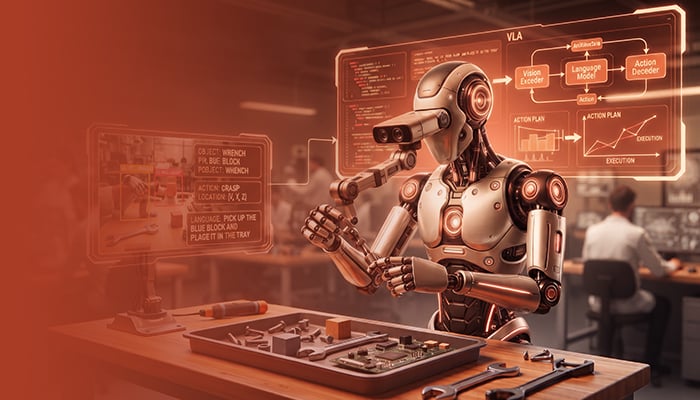
لا يتعلم نموذج الرؤية واللغة والفعل إلا عندما يتم التقاط طبقات البيانات الأربع وتصنيفها بشكل متزامن. يقدم Shaip الطبقات الأربع جميعها - المرئية واللغوية والجزء الصعب، وهو الفعل.
الخدمات
خدمات شرح VLA
تكمن صعوبة عملية إضافة التعليقات التوضيحية في مجال الروبوتات المرئية في سياق الحركة. فبينما يُعدّ تصنيف محتويات الإطار أمرًا أساسيًا، فإنّ تصنيف ما فعله الروبوت، وسبب فعله، وما إذا كان قد نجح، يُمثّل تخصصًا مختلفًا. وقد خضعت فرقنا لتدريب مُخصّص لإضافة التعليقات التوضيحية لبيانات الروبوتات متعددة الوسائط والمُستندة إلى الحركة.
شرح الحركة والمسار
نقوم بمحاذاة رموز الحركة مع الملاحظات إطارًا بإطار - تحديد نقاط الاتصال والإفراج، ووضع علامات على حدود اللغة إلى الحركة، وشرح حالات المفاصل وإزاحة المؤثر النهائي، بنسبة اتفاق بين المعلقين تزيد عن 95٪.
التعليقات متعددة الوسائط ودمج المستشعرات
نقوم بتنسيق عملية وضع العلامات عبر الرؤية + وحدة القياس بالقصور الذاتي + نظام LiDAR + الصوت + العمق، مع الحفاظ على تزامن كل تدفق زمني بحيث يتم تدريب النموذج الخاص بك على واقع متماسك ومدمج - وليس قنوات غير متوافقة.
أساسيات اللغة والتعليم
نقوم بكتابة التعليمات باللغة الطبيعية والتحقق منها ومواءمتها مع أجزاء العمل، ونتعامل مع المهام متعددة الخطوات وذات الأفق الزمني الطويل، ونقوم بتوطين الأوامر عبر أكثر من 65 لغة للروبوتات المنتشرة عالميًا.
التعليقات الدلالية، وتعليقات الأشياء والمشهد
اكتشاف وتتبع الكائنات، والتجزئة، والتعليق باستخدام LiDAR، والتعليق على سحابة النقاط، والتعليق ثلاثي الأبعاد، ووضع علامات على النقاط الرئيسية والوضع (بما في ذلك الهياكل العظمية المكونة من 42 نقطة رئيسية)، والنظرة، والإيماءة، وعلامات السياق المكاني.
تحديد النتائج والنوايا وأنماط الفشل
يتم تقييم كل حلقة من حيث النجاح أو الإكمال الجزئي أو الفشل، مع وضع علامات النية ومرحلة الحركة - وهي الإشارة التي تعتمد عليها RLHF وخطوط التقييم.
ضمان الجودة مع إشراك الإنسان في الحلقة
تضمن عمليات التحقق من صحة البيانات من قبل الخبراء، ومعالجة الاستثناءات، وحلقات المراجعة متعددة المراحل، أن تكون ملصقات الإجراءات جاهزة للإنتاج والتدقيق.
الخدمات
خدمات جمع بيانات التدريب في VLA
لا يمكن للتعليقات التوضيحية الممتازة إصلاح البيانات التي لم يتم جمعها أصلاً. يقوم Shaip بإدارة عملية جمع بيانات تدريب VLA، مما يضمن حصولك على التطبيقات والمهام والحالات الاستثنائية التي يحتاجها نموذجك بدقة.
التشغيل عن بعد وعروض الروبوتات
عروض توضيحية للروبوتات التي يتم تشغيلها عن بعد وجمع بيانات الروبوت مباشرة عبر تجسيدات متعددة - التلاعب، والتقاط ووضع الأشياء، ومهام الأفق الطويل كحلقات مسار عمل نظيفة.
فيديو توضيحي عن التمركز حول الذات والإنسان
بيانات الفيديو من منظور الشخص الأول وبيانات العرض التوضيحي البشري - قابلة للتحويل إلى تنسيق VLA عبر إعادة توجيه وضعية اليد - لتدريب السياسات مسبقًا على نطاق لا يمكن لبيانات الروبوت الحقيقية وحدها الوصول إليه.
التقاط واقعي متعدد البيئات
تم جمع البيانات من خلال أكثر من 10 بيئات واقعية - المطابخ والمنازل والشوارع والمكاتب ومرافق الرعاية الصحية والمستودعات والمصانع وورش العمل ومواقع البناء والطرق - من أجل التنوع البيئي الحقيقي.
البيانات الاصطناعية والتحسين
توليد البيانات الاصطناعية وإثرائها والتحقق من صحتها بما يتوافق مع التصنيف لملء السيناريوهات النادرة أو الخطيرة أو ذات الذيل الطويل التي لن ينتجها أسطولك بشكل طبيعي.
الأساليب التي نغطيها - جميعها متزامنة زمنيًا
الاستخدامات
حالات استخدام الذكاء الاصطناعي الفيزيائي وتقنية VLA
الروبوتات الشبيهة بالبشر
التعلم بالعرض والتلاعب الماهر.
التلاعب الروبوتي
أنظمة الانتقاء والوضع، والأتمتة في المستودعات والصناعات.
التنقل المستقل
بيانات التدريب على الإدراك، والحالات الحدية، والمركبات ذاتية القيادة.
الذكاء الاصطناعي المجسد ونماذج العالم
تدريب متعدد الوسائط قائم على العمل للوكلاء.
التفاعل بين الإنسان والروبوت
مجموعات بيانات الإيماءات والنظرات والنوايا.
الواقع المعزز/الواقع الافتراضي والذكاء الاصطناعي القابل للارتداء
بيانات التفاعل والحركة المتمركزة حول الذات.
السلامة الصناعية
معدات الوقاية الشخصية والكشف عن التصرفات غير الآمنة في بيئات حقيقية.
روبوتات الرعاية الصحية
مجموعات بيانات إعادة التأهيل والحركة السريرية.
المصانع الذكية
أتمتة المهام وبيانات فحص الجودة.
لماذا شيب
لماذا Shaip لبيانات التدريب والتعليقات التوضيحية لـ VLA
Shaip هي شركة بيانات تدريب الذكاء الاصطناعي للمؤسسات، ولديها مجموعة متكاملة مصممة للذكاء الاصطناعي المادي - وليست أداة محددة وليست سوقًا للتعهيد الجماعي.
بنية تحتية متكاملة
من تحديد النقاط إلى جمع البيانات في العالم الحقيقي، وتوليد البيانات الاصطناعية، والتحقق من صحة البيانات وفقًا لمعايير RLHF، ومعايير سيناريوهات السلامة - كل ذلك ضمن عملية واحدة.
عمق التعليقات التوضيحية متعددة الوسائط
الرؤية، والليدار، واللغة، والفعل، وسياق سير العمل - مصممة لكيفية تدريب الذكاء الاصطناعي المادي وتقييمه والوصول إلى مرحلة النشر.
بيئات واقعية + حضورية
تسجيل استوديو مُتحكم به وبيئات واقعية مباشرة - كلاهما متاحان، وكلاهما مُدار. يتضمن ذلك سيناريوهات مخصصة وتوليد حالات استثنائية.
قوة عاملة عالمية مرنة
استفد من قوة عاملة عالمية داخلية تضم أكثر من 10,000 فرد، بالإضافة إلى أكثر من 500 ألف مساهم معتمد على نطاق واسع، مع قدرة وكفاءة القوى العاملة في الوقت الفعلي.
متنوعة ودقيقة وسريعة
تعمل عمليتنا على تبسيط عملية جمع البيانات من خلال توزيع المهام بسهولة أكبر والتقاط البيانات مباشرة من التطبيق والويب.
بيانات على مستوى المؤسسات
تستخدم منصتنا الخاصة وقوتنا العاملة الماهرة أساليب متعددة لمراقبة الجودة لتلبية معايير الجودة الخاصة بك أو تجاوزها.
قصص نجاح
30,000 ساعة من الفيديوهات التي تركز على الذات لتدريب الذكاء الاصطناعي البدني
قام شايب بجمع مقاطع فيديو أصلية من منظور الشخص الأول (المتمركز حول الذات) لمنظمة تكنولوجية عالمية لتدريب نماذج التعرف على الأنشطة، والتفاعل بين اليد والأشياء، والروبوتات عبر بيئات واقعية متنوعة.
المشكلة: الحصول على فيديو أصيل وغير مصطنع يركز على الذات على نطاق واسع عبر بيئات واقعية متنوعة.
الحل: التقاط الصور عبر الهاتف المحمول المثبت على الرأس مع عملية إعداد منظمة ودورات ضمان الجودة لمدة يوم واحد - تم جمع 30,000 ساعة وتعليق أكثر من 24,000 ساعة، بحد أقصى 100 ساعة لكل مشارك.
النتيجة: مجموعة بيانات مركزية على الذات من الدرجة المناسبة للنشر مع تنوع واقعي عبر 6 مجالات نشاط وحوكمة موافقة مدمجة.
توسيع نطاق الذكاء الاصطناعي الفيزيائي والروبوتات الشبيهة بالبشر لبيانات الحركة
قام شايب ببناء خط أنابيب قابل للتطوير لالتقاط الحركة بتقنية الواقع الافتراضي، يوفر آلاف الساعات الصالحة من البيانات المتمركزة حول الذات كل شهر لتدريب الذكاء الاصطناعي المجسد والروبوتات الشبيهة بالبشر.
المشكلة: التوسع من مرحلة تجريبية إلى 5,000 ساعة التقاط حركة صالحة شهريًا عبر بيئات متنوعة و300-400 مهمة.
الحل: تتبع الحركة بتقنية الواقع الافتراضي باستخدام خمسة مستشعرات مع معايرة إلزامية عبر أكثر من 50 إعدادًا للمشاهد في ستة أنواع من البيئات، بالإضافة إلى ضمان الجودة الكامل.
النتيجة: تسليم شهري مستدام لمجموعات البيانات الجاهزة للتعليق مع 1,500-2,500 مشارك لكل دورة للذكاء الاصطناعي المجسد والروبوتات الشبيهة بالبشر.
طريقة عملنا
كيف تعمل هذه التقنية؟
سير عمل شفاف قائم على مراحل محددة، مصمم لتقليل المخاطر في مشروعك منذ اليوم الأول.النطاق والتصنيف
نتفق على التجسيدات والمهام ومساحة العمل وأجهزة الاستشعار ومعايير النجاح - قبل التقاط إطار واحد.
قم بجمعها أو تناولها
نقوم بتشغيل عمليات التشغيل عن بعد، والتحليل الذاتي، والتقاط البيانات من العالم الحقيقي، أو نقوم باستيعاب بيانات أسطولك الحالية وهيكلتها.
أضف تعليقاتك وادمجها
تصنيف الأفعال واللغة والوسائط المتعددة والنتائج مع ضمان الجودة المتزامن الذي يشارك فيه الإنسان.
التحقق والتسليم
التحقق من صحة البيانات، والمعايير المرجعية، ومجموعات الحالات الاستثنائية، المقدمة بتنسيق جاهز للتدريب.
الأمان والامتثال
قم ببناء نموذج VLA الخاص بك على بيانات يمكنك الوثوق بها
سواء كنت تقوم بتدريب إنسان آلي، أو نظام مستقل، أو وكيل ذكاء اصطناعي مجسد، فإن Shaip يمنحك بيانات التدريب والتعليقات التوضيحية الخاصة بـ VLA للوصول إلى هناك بشكل أسرع - دقيق، قائم على العمل، وآمن للمؤسسات.
اتصل بناالأسئلة الأكثر شيوعًا (FAQ)
1. ما هي بيانات تدريب VLA؟
بيانات تدريب VLA هي مجموعة البيانات المتزامنة المستخدمة لتدريب نماذج الرؤية واللغة والحركة - حيث يتم ربط الملاحظات المرئية وتعليمات اللغة الطبيعية ومسارات الحركة وتصنيفات النتائج في حلقات يمكن للروبوت أن يتعلم منها.
2. ما الفرق بين التعليقات التوضيحية باستخدام VLA والتعليقات التوضيحية القياسية للصور أو الفيديو؟
تُصنّف التعليقات التوضيحية القياسية ما يظهر في الإطار. كما تُصنّف تعليقات VLA ما فعله الوكيل - من خلال ربط رموز الإجراءات بالملاحظات، وتحديد نقاط الاتصال واستعادة النظام في حالة الفشل، وربط اللغة بالإجراءات بمرور الوقت.
3. ما هي البيانات التي تحتاجها نماذج الرؤية واللغة والحركة؟
أربع طبقات: الملاحظات المرئية (RGB/العمق)، تعليمات اللغة، مسارات الحركة التي تم رسمها على درجات حرية الروبوت، وعلامات نتائج النجاح/الفشل - من الناحية المثالية عبر العديد من التجسيدات والبيئات للتعميم.
4. هل يستطيع Shaip جمع بيانات VLA مخصصة، أم أنه يكتفي فقط بتعليق بياناتنا؟
كلاهما. يقوم Shaip بإدارة عمليات التشغيل عن بعد، والبيانات الذاتية، وجمع بيانات التدريب على VLA متعددة البيئات، كما يقوم أيضًا بتعليق البيانات الموجودة لديك بالفعل والتحقق منها وتوسيعها.
5. هل تدعمون تقنية LiDAR، والسحابة النقطية، ودمج البيانات من أجهزة استشعار متعددة؟
نعم — LiDAR، سحابة النقاط، ثلاثي الأبعاد، الرادار، IMU، العمق، الصوت، والقوة/العزم، جميعها متزامنة زمنيًا لتدريب دمج المستشعرات.
6. كيف تضمن شركة Shaip الجودة وأمن البيانات؟
إدارة فرق الخبراء مع ضمان الجودة البشري في الحلقة و >95٪ اتفاق بين المعلقين على تسميات الإجراءات، بموجب ضوابط ISO 27001 و SOC 2 Type II و GDPR/HIPAA الجاهزة.