يمكن أن يساعد تحليل البيانات المنظمة في تحسين التشخيص ورعاية المرضى. ومع ذلك، فإن تحليل البيانات غير المنظمة يمكن أن يؤدي إلى تحقيق اختراقات واكتشافات طبية ثورية.
هذا هو جوهر الموضوع الذي سنناقشه اليوم. ومن المثير للاهتمام أن نلاحظ أن العديد من التطورات الجذرية في مجال تكنولوجيا الرعاية الصحية حدثت بنسبة 10-20% فقط من بيانات الرعاية الصحية القابلة للاستخدام.
تكشف الإحصائيات أن أكثر من 90% من البيانات في هذا الطيف غير منظمة، مما يعني أن البيانات أقل قابلية للاستخدام وأكثر صعوبة في الفهم والتفسير والتطبيق. من البيانات التناظرية مثل وصفة الطبيب إلى البيانات الرقمية في شكل صور طبية وبيانات سمعية وبصرية، تنقسم البيانات غير المنظمة إلى أنواع مختلفة.
إن مثل هذه الكميات الضخمة من البيانات غير المنظمة تشكل موطناً لرؤى مذهلة يمكنها تسريع التقدم في مجال الرعاية الصحية لعقود من الزمن. وسواء كان الأمر يتعلق بمساعدة اكتشاف الأدوية لعلاج الأمراض المناعية الذاتية الخطيرة التي تستهلك الحياة أو البيانات التي يمكن أن تساعد شركات التأمين الصحي في تقييم المخاطر، فإن البيانات غير المنظمة يمكن أن تمهد الطريق لاحتمالات غير معروفة.
عندما تتحقق هذه الطموحات، يصبح تفسير بيانات الرعاية الصحية وقابليتها للتشغيل البيني أمراً بالغ الأهمية. ومع وجود إرشادات صارمة وإنفاذ للامتثال التنظيمي مثل اللائحة العامة لحماية البيانات (GDPR) وقانون قابلية نقل التأمين الصحي والمساءلة (HIPAA)، يصبح إخفاء هوية بيانات الرعاية الصحية أمراً لا مفر منه.
لقد سبق أن نشرنا مقالاً شاملاً حول تبسيط فهم بيانات الرعاية الصحية المنظمة وغير المنظمة . كما يوجد مقال مخصص (وشامل) حول إخفاء هوية بيانات الرعاية الصحية . ننصحكم بقراءتهما للحصول على معلومات متكاملة، حيث سنخصص هذا المقال لموضوع خاص حول إخفاء هوية البيانات غير المنظمة.
التحديات في إزالة هوية البيانات غير المنظمة
كما يوحي الاسم، فإن البيانات غير المهيكلة غير منظمة، بل هي متناثرة من حيث التنسيقات وأنواع الملفات والأحجام والسياق وغير ذلك. ومجرد وجود هذه البيانات بأشكال مختلفة كالصوت والنصوص والصور الطبية والبيانات التناظرية وغيرها، يجعل فهم مُعرّفات المعلومات الشخصية (PII) أكثر صعوبة، وهو أمر بالغ الأهمية في إخفاء هوية البيانات غير المهيكلة.
ولإعطائكم لمحة عن التحديات الأساسية، إليكم قائمة سريعة:

- فهم السياق - حيث يصعب على أصحاب المصلحة في مجال الذكاء الاصطناعي فهم السياق المحدد وراء جزء أو جانب معين من البيانات غير المنظمة. على سبيل المثال، قد يؤدي فهم ما إذا كان الاسم هو اسم شركة أو اسم شخص أو اسم منتج إلى معضلة حول ما إذا كان يجب إزالة هويته.
- البيانات غير النصية - حيث يمكن أن يكون تحديد الإشارات السمعية أو البصرية للأسماء أو المعلومات الشخصية القابلة للتعريف مهمة شاقة حيث قد يتعين على صاحب المصلحة الجلوس لساعات وساعات من اللقطات أو التسجيلات في محاولة لإلغاء تحديد الجوانب المهمة.
- غموض – وهذا صحيح بشكل خاص في سياق البيانات التناظرية مثل وصفة الطبيب أو إدخال المستشفى في سجل. فمن الكتابة اليدوية إلى القيود المفروضة على التعبير باللغة الطبيعية، قد يجعل هذا من إزالة هوية البيانات مهمة معقدة.
أفضل الممارسات لإزالة هوية البيانات غير المنظمة
تختلف عملية إزالة المعلومات الشخصية الحساسة من البيانات غير المهيكلة اختلافًا كبيرًا عن عملية إخفاء هوية البيانات المهيكلة، ولكنها ليست مستحيلة. فمن خلال اتباع نهج منهجي وسياقي، يمكن الاستفادة من إمكانات البيانات غير المهيكلة بسلاسة. دعونا نستعرض الطرق المختلفة لتحقيق ذلك.
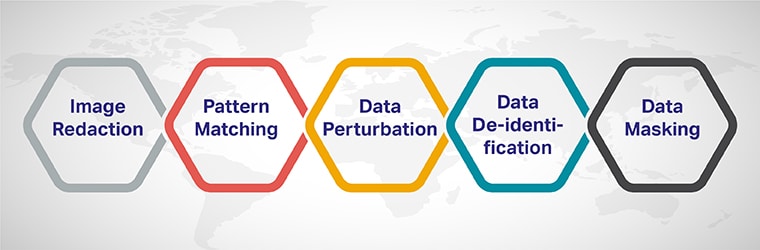
تنقيح الصور: يتعلق هذا الإجراء ببيانات التصوير الطبي، ويتضمن إزالة بيانات تعريف المريض وتشويه المراجع التشريحية وأجزاء من الصور. ويتم استبدال هذه البيانات بأحرف خاصة للحفاظ على وظائفها التشخيصية وفائدتها.
مطابقة الأنماط: يمكن اكتشاف بعض المعلومات الشخصية الأكثر شيوعًا مثل الأسماء وتفاصيل الاتصال والعناوين وإزالتها باستخدام حكمة دراسة الأنماط المحددة مسبقًا.
الخصوصية التفاضلية أو تشويش البيانات: يتضمن ذلك إدراج ضوضاء محكومة لإخفاء البيانات أو السمات التي يمكن تتبعها إلى فرد ما. لا تضمن هذه الطريقة المثالية إخفاء هوية البيانات فحسب، بل تضمن أيضًا الاحتفاظ بالخصائص الإحصائية لمجموعة البيانات للتحليلات.
إخفاء هوية البيانات: تُعدّ هذه إحدى أكثر الطرق موثوقية وفعالية لإزالة المعلومات الشخصية الحساسة من البيانات غير المهيكلة. ويمكن تطبيق ذلك بإحدى طريقتين:
- الإشراف على التعلم - حيث يتم تدريب النموذج على تصنيف النص أو البيانات على أنها معلومات شخصية قابلة للتعريف أو غير قابلة للتعريف
- تعليم غير مشرف عليه - حيث يتم تدريب النموذج على التعلم بشكل مستقل لاكتشاف الأنماط في تحديد معلومات التعريف الشخصية
تضمن هذه الطريقة حماية خصوصية المريض مع الإبقاء على التدخل البشري في الجوانب الأقل أهمية من المهمة. ويمكن لأصحاب المصلحة ومقدمي بيانات الرعاية الصحية الذين يستخدمون تقنيات التعلم الآلي لإخفاء هوية البيانات غير المهيكلة، ببساطة، تطبيق عملية ضمان جودة مدعومة بالتدخل البشري لضمان عدالة النتائج وملاءمتها ودقتها.
إخفاء البيانات: إخفاء البيانات هو التلاعب الرقمي بالألفاظ لإخفاء هوية بيانات الرعاية الصحية، حيث يتم جعل المعرفات المحددة عامة أو غامضة من خلال تقنيات متخصصة مثل:
- الرمزية – تتضمن استبدال معلومات التعريف الشخصية بأحرف أو رموز
- التعميم- عن طريق استبدال قيم PII المحددة بقيم عامة/غامضة
- خلط الأوراق من خلال خلط معلومات التعريف الشخصية لجعلها غامضة
ومع ذلك، تأتي هذه الطريقة مع قيد يتمثل في أنه باستخدام نموذج أو نهج متطور، يمكن إعادة تحديد البيانات
الاستعانة بمصادر خارجية للاعبين في السوق
إنّ النهج الأمثل لضمان عملية إخفاء هوية البيانات غير المهيكلة بشكل محكم ودقيق ومتوافق مع إرشادات قانون HIPAA هو إسناد هذه المهام إلى مزود خدمة موثوق مثل Shaip . بفضل نماذجنا المتطورة وبروتوكولات ضمان الجودة الصارمة، نضمن الحدّ من التدخل البشري في خصوصية البيانات في جميع الأوقات.
نظرًا لكوننا شركة مهيمنة على السوق لسنوات، فإننا ندرك أهمية مشاريعك. لذا، تواصل معنا اليوم لتحسين طموحاتك في مجال الرعاية الصحية باستخدام بيانات الرعاية الصحية التي تم إخفاء هويتها بواسطة Shaip.