لم يعد بناء سياسة روبوتية فعّالة في العالم الحقيقي مشكلة حاسوبية، بل أصبح مشكلة بيانات. أمام فرق الذكاء الاصطناعي المُجسّد ثلاثة خيارات لتغذية نماذجها: التحكم عن بُعد، والمحاكاة، وتسجيلات الفيديو البشري. لكل خيار منها تكلفة مختلفة، ومستوى دقة مختلف، وحدود قصوى مختلفة لما يمكن أن يتعلمه الروبوت في نهاية المطاف. قد يؤدي اختيار المصدر الأساسي الخاطئ إلى إهدار ستة أشهر وميزانية ضخمة قبل اكتشاف ذلك. يُفصّل هذا الدليل كل مصدر من مصادر البيانات للذكاء الاصطناعي المُجسّد، ويُبيّن مزاياه وعيوبه، وكيفية دمجها في استراتيجية بيانات تدريب روبوتية عالية الجودة.
الوجبات السريعة الرئيسية
- تنتج عمليات التشغيل عن بعد بيانات عالية الدقة ولكنها تعاني من اختناق عند 5-50 حلقة لكل ساعة تشغيل.
- تُنتج المحاكاة ملايين الحلقات بتكلفة منخفضة، لكنها تُحدث فجوة بين المحاكاة والواقع، مما يؤدي إلى فشل المهام التي تتطلب اتصالاً مكثفاً.
- تتوسع مقاطع الفيديو التي تُظهر البشر بسهولة، لكنها تفتقر إلى تصنيفات حركة الروبوتات وتحمل فجوة في التجسيد.
- تُظهر الأبحاث الحديثة أن ما يقرب من 8 عينات محاكاة تقدم قيمة عينة واحدة يتم تشغيلها عن بعد للمهام داخل المجال.
- تجمع معظم خطوط إنتاج الذكاء الاصطناعي المتجسدة بين المصادر الثلاثة جميعها بدلاً من اختيار مصدر واحد.
لماذا تُعتبر البيانات هي العائق الرئيسي في الذكاء الاصطناعي المجسد؟
تُشكّل البيانات العائق الرئيسي في الذكاء الاصطناعي المُجسّد، إذ لا تتوفر بيانات حسية حركية مرتبطة بالأفعال على نطاق الإنترنت. يستطيع نموذج اللغة استيعاب تريليون رمز نصي مُستخرج من الويب. بينما تحتاج سياسة الروبوت إلى زوايا مفاصل متزامنة، وقوى قابض، وإطارات كاميرا، وسياق المهمة - وكلها مُسجلة أثناء التلاعب المادي. لا شيء من هذا مُتاح مجانًا.
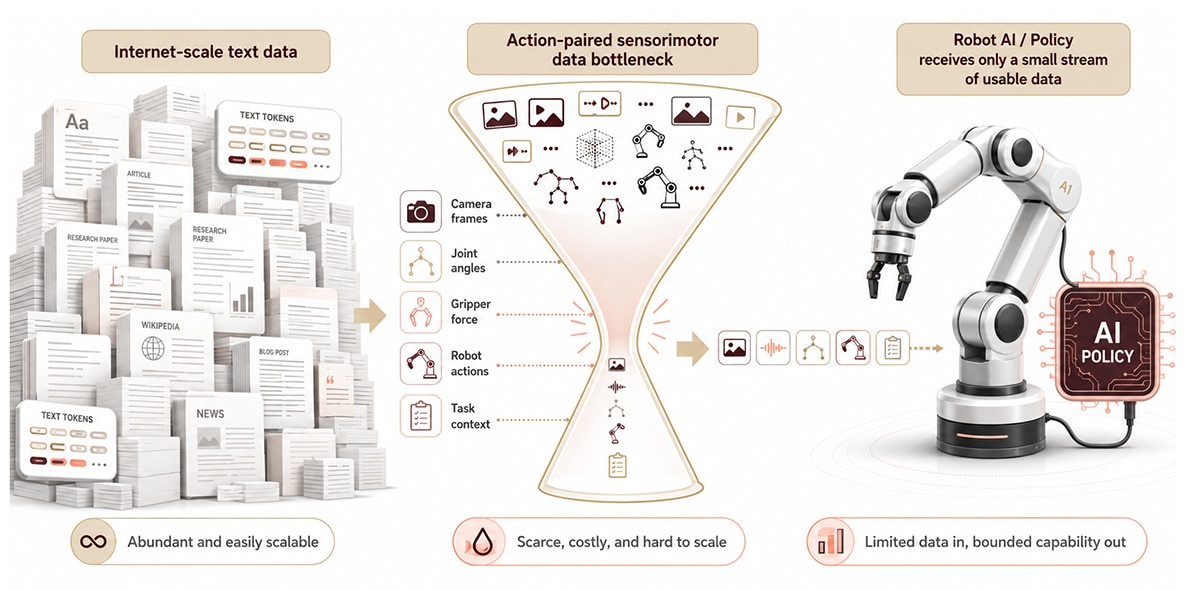
الفجوة في الحجم هائلة. يعمل أكثر من 3.9 مليون روبوت صناعي على مستوى العالم (المؤتمر الدولي للروبوتات العالمية، 2024)، ومع ذلك، فإن أكبر مجموعة بيانات مفتوحة لمعالجة الروبوتات تحتوي على ما يقارب مليون حالة فقط (Open X-Embodiment، بادالكار وآخرون، 2023). الأجهزة متوفرة بكثرة، لكن البيانات نادرة. كل نموذج جديد - سواء كان ذراعًا واحدة، أو روبوتًا بشريًا ثنائي اليدين، أو قاعدة متحركة بذراع - يُعيد ضبط متطلبات البيانات، لأن السياسات المُدرَّبة على نموذج واحد نادرًا ما تنتقل بسلاسة إلى نموذج آخر.
فجوة التجسيد: فقدان الأداء الذي يحدث عند نشر سياسة تم تدريبها على التكوين المادي لروبوت واحد على روبوت مختلف.
لهذا السبب، باتت فرق تعلم الروبوتات تفكر الآن من منظور استراتيجية البيانات، وليس مجرد جمعها. فالمزيج الأمثل من التحكم عن بُعد والمحاكاة والمشاهدة البشرية هو ما يحدد قدرات النموذج، وسرعة إنجازه، والتكلفة اللازمة لذلك.
ما هي بيانات التشغيل عن بعد ومتى تكون هي المنتصرة؟
يتم تسجيل بيانات التشغيل عن بعد عندما يتحكم مشغل بشري في الروبوت في الوقت الفعلي من خلال ذراع القيادة أو سماعة الواقع الافتراضي أو الهيكل الخارجي أو واجهة مثبتة على المعصم، بينما يقوم النظام بتسجيل كل زاوية مفصل وقراءة قوة وإطار كاميرا بشكل متزامن.
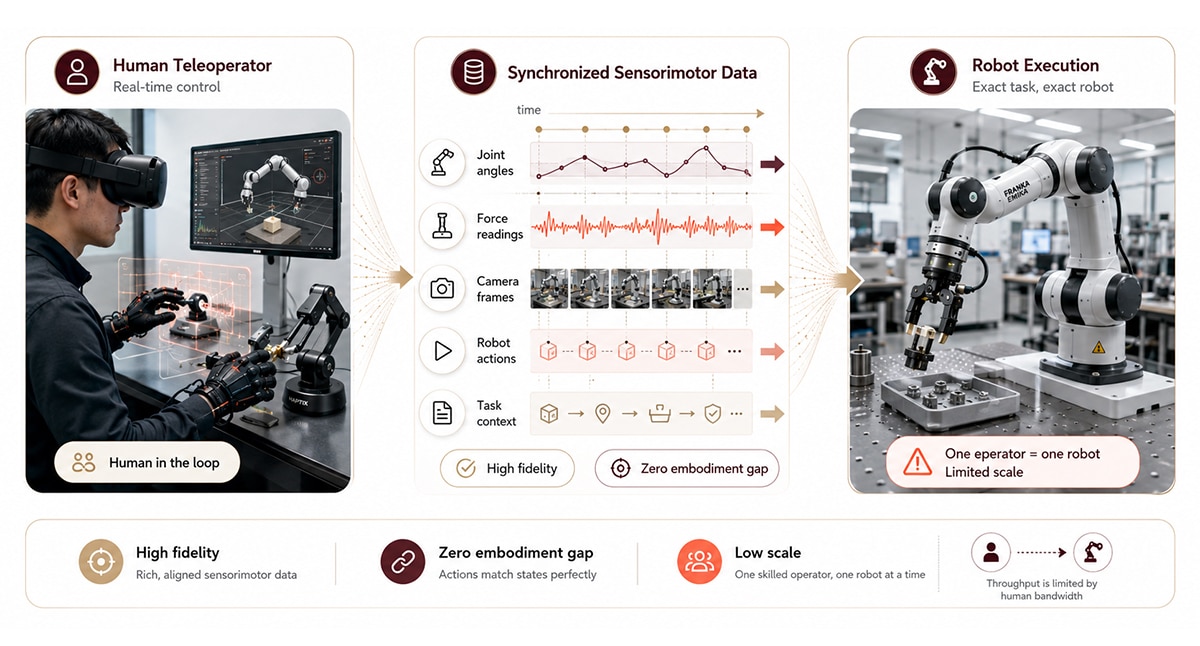
التشغيل عن بعد: التحكم البشري في الوقت الحقيقي في الروبوت باستخدام بيانات حسية حركية متزامنة مسجلة أثناء التلاعب.
تتفوق تقنية التحكم عن بُعد من حيث الدقة. فبفضل البيانات التي يُنتجها إنسانٌ ماهرٌ يؤدي المهمة نفسها على الروبوت نفسه، يكون التطابق بين الفعل والحالة مثاليًا، وتختفي فجوة التجسيد. ويستفيد كلٌ من التعلّم بالتقليد، واستنساخ السلوك، وضبط السياسات بدقة من عروض التحكم عن بُعد الواضحة.
تظهر التكلفة عند التوسع. ينتج المشغل الماهر عن بُعد ما بين 5 إلى 50 حلقة في الساعة، وذلك بحسب تعقيد المهمة، وتتراجع الجودة مع إرهاق المشغلين. روبوت واحد، ومشغل واحد - هذا هو الحد الأقصى، ولهذا السبب ركزت المنصات المفتوحة مثل ALOHA وUMI والأنظمة الروبوتية البشرية القائمة على الهياكل الخارجية (AgiBot، Fourier GR-1) على خفض التكاليف وزيادة الإنتاجية بدلاً من التوسع الجذري.
تعمل خدمات بيانات الذكاء الاصطناعي الفيزيائي من Shaip على تشغيل خلايا التحكم عن بعد جنبًا إلى جنب مع سير عمل جمع البيانات متعدد الوسائط، بحيث لا تضطر فرق الروبوتات إلى بناء خطوط أنابيب التشغيل من الصفر.
ما هي بيانات المحاكاة وأين يتم توسيع نطاقها؟
تُنتج بيانات المحاكاة بواسطة محركات فيزيائية مثل MuJoCo وNVIDIA Isaac Sim وIsaac Lab وPyBullet، والتي تُجسّد روبوتات افتراضية تُنفّذ مهامًا عبر آلاف النسخ المتوازية. ويمكن لمجموعة واحدة من وحدات معالجة الرسومات (GPU) إنتاج ملايين الحلقات خلال ليلة واحدة بتكلفة هامشية شبه معدومة.
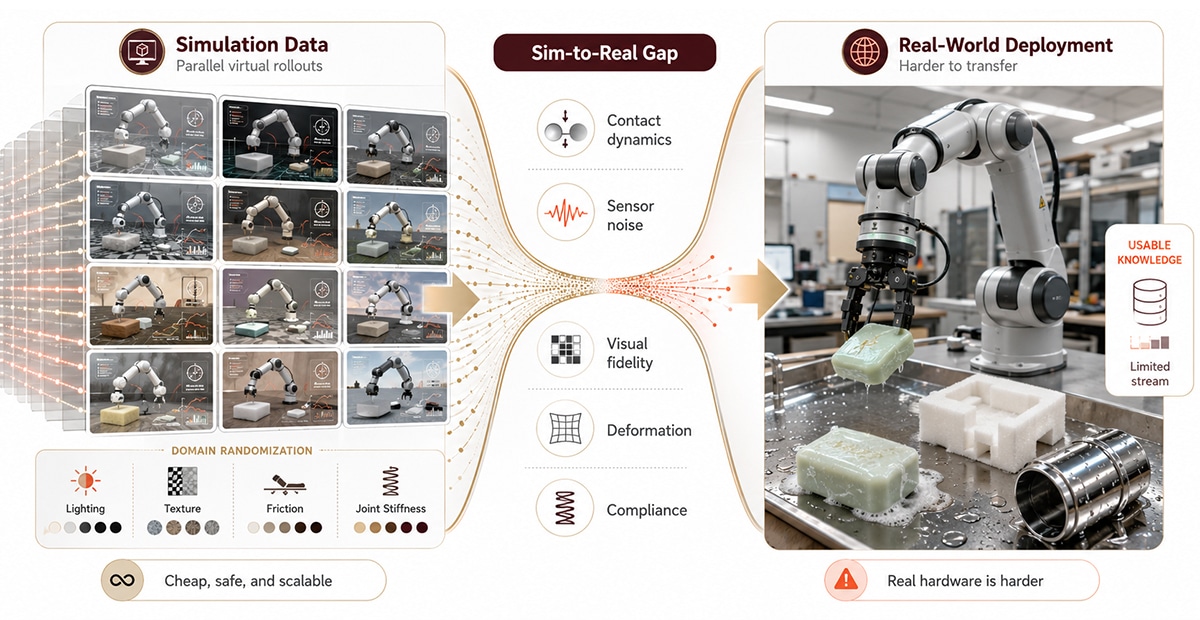
تتفوق المحاكاة من حيث النطاق والسلامة. إذ يمكن استكشاف الحالات الاستثنائية، وأعطال التصادم، والتكوينات الخطرة دون إتلاف الأجهزة. كما أن عشوائية المجال - أي تغيير الإضاءة، والقوام، والاحتكاك، وصلابة المفاصل بشكل عشوائي أثناء التدريب - تُنتج سياسات تتكيف مع التغيرات الواقعية بدلاً من الاعتماد المفرط على تكوين بصري واحد.
الفجوة بين المحاكاة والواقع: انخفاض الأداء عند نشر سياسة تم تدريبها في المحاكاة على أجهزة مادية، وعادة ما يكون سببها ديناميكيات الاتصال، وضوضاء المستشعر، واختلافات الدقة البصرية.
تظهر التكلفة عند التطبيق العملي. لا تحاكي أنظمة المحاكاة احتكاك قطعة صابون رطبة، أو مرونة عبوات الرغوة، أو التباين البصري للمعادن اللامعة تحت إضاءة الفلورسنت. وتُعدّ المهام التي تتطلب تلامسًا مباشرًا هي الأكثر عرضةً للفشل في محاكاة الواقع. وقد حدّد بحث نُشر عام 2025 هذه المفاضلة كميًا: إذ تُقدّم ثماني عينات محاكاة تقريبًا فائدةً تُعادل فائدة عينة واحدة يتم تشغيلها عن بُعد في مهام التلاعب ضمن نطاق التطبيق (قانون استخدام البيانات للتلاعب الروبوتي، 2025).
تعمل منصات العرض الواقعية مثل NVIDIA Cosmos و 3D Gaussian Splatting على تضييق الفجوة البصرية، لكن الفجوة الديناميكية - الاحتكاك والتشوه والمرونة - لا تزال هي المشكلة الأصعب.
[اقرأ أيضاً: البيانات الاصطناعية مقابل البيانات الواقعية في مجال الروبوتات ]
ما هي بيانات الفيديو البشري وماذا تكشف؟
بيانات الفيديو البشري هي لقطات لأشخاص يقومون بمهام التلاعب - طي الغسيل، وتكديس الأطباق، وتجميع المكونات - تم التقاطها من كاميرات مركزية، أو زوايا مراقبة، أو مجموعات عرض توضيحية منسقة.
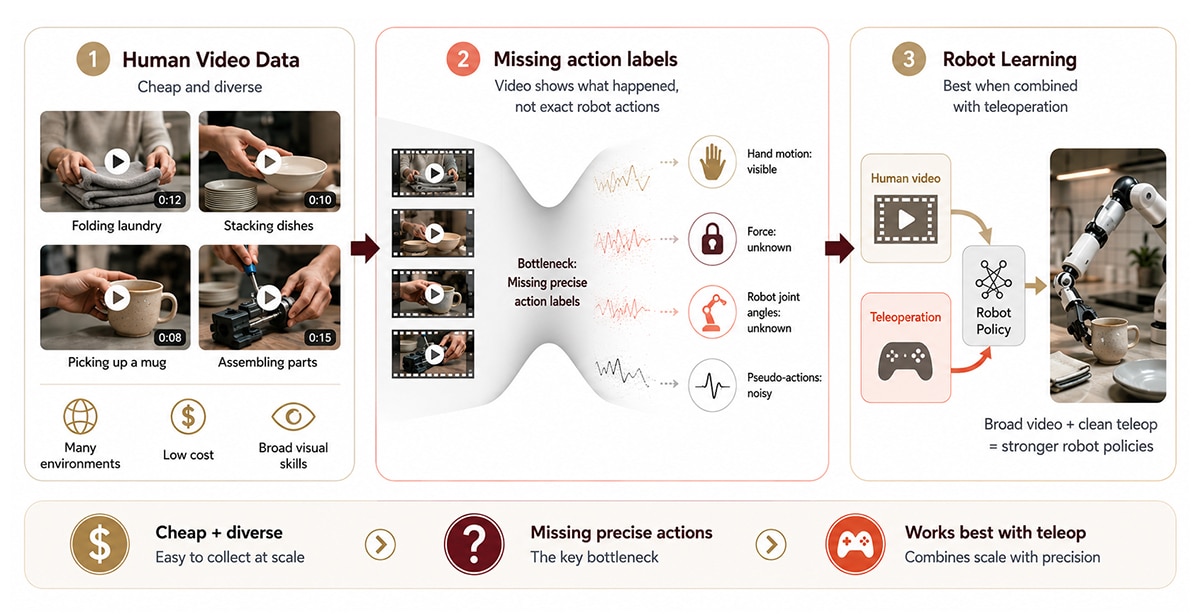
يتفوق الفيديو البشري من حيث التكلفة والتنوع. إذ يمكن لشخص واحد، باستخدام هاتف ذكي، تصوير مئات العروض التوضيحية في المطابخ والمرائب والمصانع والمكاتب في فترة ما بعد الظهيرة. لا حاجة إلى روبوت، ولا مختبر، ولا تدريب للمشغلين. تكتسب نماذج الرؤية واللغة الكبيرة، المدربة مسبقًا على فيديوهات بشرية، فهمًا عامًا للمشهد، وهو ما يُفيد في تطبيق سياسات الروبوت قبل ضبطها بدقة.
يكمن القيد في غياب بيانات الحركة. يُظهر الفيديو يدًا تمسك كوبًا، لكنه لا يُسجل القوة المُطبقة أو زوايا المفاصل التي يحتاجها ذراع الروبوت لمحاكاة الحركة. يمكن لنماذج الديناميكا العكسية وإعادة توجيه اليد إلى أداة النهاية استنتاج هذه البيانات جزئيًا، لكن الحركات الزائفة الناتجة تحمل تشويشًا.
تخيل شركة ناشئة تُطوّر روبوتًا للمطبخ. لديهم 80 ألف دولار لإنفاقها. قد تُمكّنهم 20 ساعة من التشغيل عن بُعد من الحصول على 200 مقطع فيديو واضح لذراعهم المُستهدفة. بينما تُمكّنهم 20 ساعة من جمع مقاطع الفيديو من مُستخدمين مُختلفين في مطابخ منزلية مُتنوعة من الحصول على آلاف المقاطع التي تُركّز على الروبوت نفسه. جودة الصورة عبر الهاتف أفضل، بينما جودة الفيديو أوسع. يحتاج الروبوت إلى كليهما، بنسب مُختلفة في مراحل التدريب المُختلفة.
[اقرأ أيضًا: بيانات تدريب الروبوت ومجموعات بيانات التلاعب ]
مقارنة بين التشغيل عن بعد والمحاكاة والفيديو البشري: مقارنة جنبًا إلى جنب
كيف تختار استراتيجية البيانات المناسبة للذكاء الاصطناعي المجسد؟
يبدأ اختيار استراتيجية بيانات تدريب الروبوت المناسبة بتحديد الهدف من النشر، وليس مصدر البيانات. فلكل من روبوت المصنع المخصص للالتقاط والوضع، والروبوت المنزلي الشبيه بالإنسان، ومساعد الجراحة، متطلبات مختلفة جذريًا من حيث الدقة والسلامة والتجسيد، وبالتالي، مزيج بيانات مثالي مختلف جذريًا. وتتطلب الروبوتات الشبيهة بالإنسان، على وجه الخصوص، متطلبات خاصة قبل النشر، والتي نفصّلها في دليلنا لبيانات تدريب الروبوتات الشبيهة بالإنسان.
إطار عمل عملي من ثلاث خطوات:
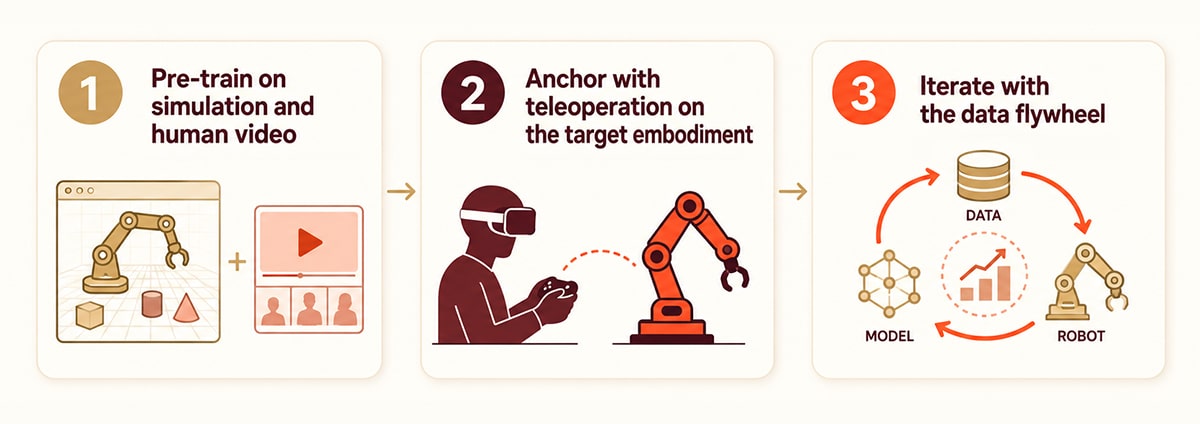
- التدريب المسبق على المحاكاة والفيديو البشري. استخدم المحاكاة لتغطية شاملة للمشاهد والأشياء وحالات السلامة الحرجة. أضف مقاطع فيديو من منظور بشري لإضفاء طابع طبيعي على التفاعلات المسبقة والتنوع البصري الواقعي. هذه المرحلة غير مكلفة وواسعة النطاق.
- تثبيت مع تشغيل عن بعد على النموذج المستهدف. اجمع ما بين 500 و2,000 حلقة مراقبة عن بُعد عالية الجودة على الروبوت الذي تنوي نشره تحديدًا. هذه المرحلة مكلفة لكنها لا غنى عنها، فهي تُرسّخ السياسة في ديناميكيات واقعية.
- قم بالتكرار باستخدام عجلة البيانات. بعد النشر، قم بتسجيل عمليات الإطلاق التلقائي وحالات الفشل. ثم قم بتضمينها في دورة التدريب التالية إلى جانب مقاطع الفيديو الجديدة من عمليات التشغيل عن بعد والمشاهدة البشرية.
فكّر في الأمر كتدريب طاهٍ. المحاكاة هي بمثابة مدرسة فنون الطهي - شاملة، وغير مكلفة، وتتيح تقبّل الأخطاء. أما التدريب العملي فهو مشاهدة آلاف الفيديوهات التعليمية عن الطبخ - سياق واسع، دون وجود مطبخ خاص بك. بينما التدريب عن بُعد هو التدريب العملي في المطبخ الفعلي الذي ستعمل فيه - بطيء، ومكلف، ولا غنى عنه. لا يتجاهل أي طاهٍ محترف أيًا من هذه المراحل الثلاث.
تم تصميم عمليات جمع البيانات متعددة الوسائط والتعليقات التوضيحية الخاصة بـ Shaip لدعم الطبقات الثلاث جميعها - عمليات خلايا التحكم عن بعد، ووضع علامات المحاكاة، وجمع الفيديو من منظور الشخص الأول من خلال شبكة عالمية تضم أكثر من 500 ألف مساهم - بحيث يمكن لفرق الروبوتات تنسيق استراتيجية هجينة دون الحاجة إلى ربط خمسة موردين معًا.
خاتمة
سيُحسم الجدل الدائر حول التحكم عن بُعد مقابل المحاكاة مقابل الفيديو البشري بحلول عام 2026: إنه ليس خيارًا، بل مجموعة متكاملة. يمنحك التحكم عن بُعد دقة عالية، بينما تمنحك المحاكاة نطاقًا واسعًا، ويمنحك الفيديو البشري تنوعًا. تجمع خطوط إنتاج الذكاء الاصطناعي المُجسّد بين هذه العناصر الثلاثة، مع مراعاة هدف النشر، ونوع التجسيد، والميزانية. لن تكون الفرق التي ستفوز في العقد القادم من تعلم الروبوتات هي تلك التي تختار المصدر الأرخص، بل تلك التي تُنسق المزيج الأمثل.