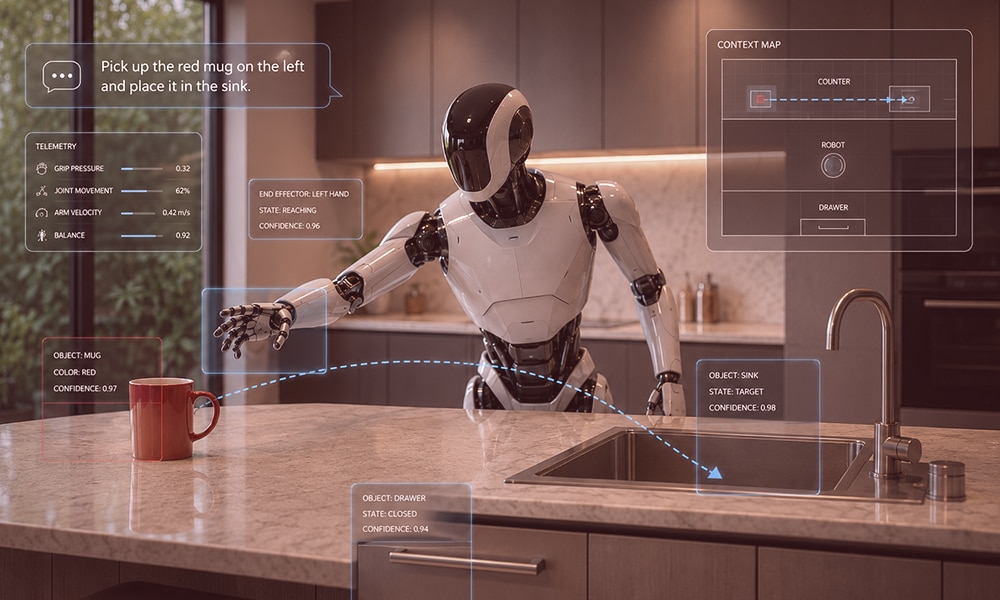
معظم نماذج الروبوتات تعمل بكفاءة تامة في العرض التوضيحي، لكنها تفشل عند التطبيق العملي. والسبب نادرًا ما يكون في بنية النموذج، بل في البيانات. فالنموذج المُدرَّب على أسطح طاولات مُصممة مسبقًا وأشياء متوقعة ينهار بمجرد رؤيته شقة فوضوية أو ممرًا حقيقيًا في مستودع. ولتدارك هذه الفجوة، صُممت بيانات تدريب الروبوتات ومجموعات بيانات معالجة الروبوتات خصيصًا لهذا الغرض: فهي تُتيح التقاط الإشارات المعقدة والمتعددة الوسائط على مستوى كل حالة، والتي تُمكّن الروبوت من التعميم من بيئة المختبر إلى غرفة المعيشة.
الوجبات السريعة الرئيسية
- بيانات تدريب الروبوت هي بيانات متعددة الوسائط متزامنة زمنياً تجمع بين تدفقات الرؤية والمستشعرات والحركة.
- تُعد مجموعات بيانات معالجة الروبوتات مجموعة فرعية غنية بالمعلومات التي تُعلّم الإمساك والوضع والتجميع.
- تجمع خطوط نقل البيانات في مجال الروبوتات بين التنوع الناتج عن مصادر جماعية والدقة في الموقع - فكل منهما على حدة لا يكفي.
- يشمل التعليق التوضيحي تصنيف الإطارات، ووضع علامات على الأحداث الزمنية، وتقييم تنفيذ المهام.
- بيانات الروبوتات، على عكس بيانات LLM، تتطلب ضمان الجودة من خلال تدخل بشري مع حدس فيزيائي.
ما هي بيانات تدريب الروبوت؟
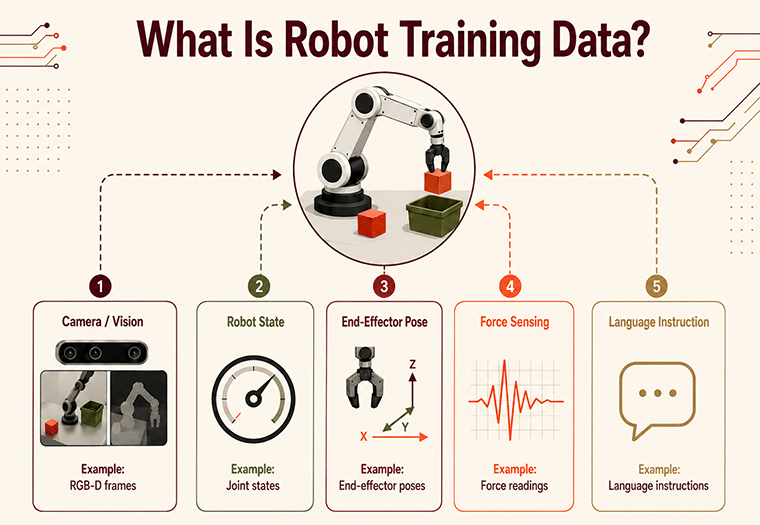
بيانات تدريب الروبوت هي بيانات متعددة الوسائط متزامنة زمنيًا، تجمع بين بيانات الرؤية، وبيانات الاستشعار، وبيانات الحركة، وتُستخدم لتدريب نماذج الإدراك والتحكم الروبوتية. كل حلقة تربط ما رآه الروبوت بما فعله - إطارات RGB-D، وحالات المفاصل، ووضعيات الطرف النهائي، وقراءات القوة، وتعليمات اللغة المسجلة في طوابع زمنية مشتركة.
بيانات التشغيل عن بعد: بيانات عرض الروبوت التي يتم جمعها عندما يقوم مشغل بشري بالتحكم عن بعد في الروبوت من خلال مهمة باستخدام ذراع القيادة أو وحدة تحكم الواقع الافتراضي أو جهاز التقاط الحركة.
هذا التزامن الزمني هو ما يجعل البيانات قابلة للتدريب كسياسة. بدونه، لديك فيديو - مفيد للإدراك، وغير مفيد للتحكم.
كيف تختلف مجموعات بيانات معالجة الروبوت عن بيانات تدريب الروبوت العامة؟
مجموعة بيانات معالجة الروبوت: مجموعة منظمة من مسارات الروبوت التي تلتقط تفاعلات الأشياء مثل الإمساك أو الوضع أو التجميع أو استخدام الأدوات، مع ملاحظات وإجراءات متزامنة لكل خطوة زمنية.
تشمل بيانات تدريب الروبوتات العامة كل ما يمكن أن يفعله الروبوت - الملاحة، والحركة، والإدراك. أما مجموعات بيانات التلاعب فتركز على الجانب الغني بالتواصل والمهارة الذي لا يزال غير مكتمل. وتجمع بيانات التجسيد المتعدد العروض التوضيحية عبر منصات روبوتية مختلفة لتحسين مدى جودة نقل السياسة إلى أجهزة جديدة.
[اقرأ أيضًا: استراتيجية بيانات تدريب الروبوت ]
ما هي أنواع بيانات تدريب الروبوتات التي تغذي نماذج الروبوتات الحديثة؟
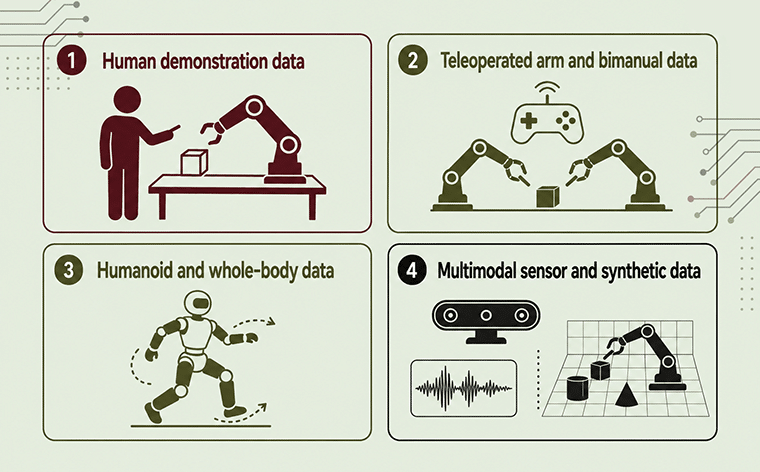
بيانات توضيحية بشرية
فيديوهات من منظور الشخص الأول لأشخاص يؤدون مهام يومية - مثل طي الملابس، وسكب السوائل، وفتح البرطمانات - تم التقاطها باستخدام كاميرات مثبتة على الرأس ووحدات قياس القصور الذاتي القابلة للارتداء. تُستخدم هذه الفيديوهات بكثرة في التدريب المسبق وفي المهام التي يكون فيها التقاط الروبوتات لها مباشرةً غير عملي.
ذراع يتم التحكم فيه عن بعد وبيانات ثنائية اليد
المعيار الذهبي للتحكم الآلي. يقوم مشغل بشري بتوجيه الروبوت خلال العروض التوضيحية باستخدام ذراع تحكم أو جهاز واقع افتراضي. ولا تزال البيانات ثنائية اليد (تنسيق حركة الذراعين) هي النوع الفرعي الأندر والأكثر قيمة.
بيانات الإنسان الآلي والجسم بالكامل
تم التقاط هذه البيانات من منصات بشرية تقوم بالحركة والتحكم في آن واحد. وتشمل المصادر بدلات التقاط الحركة، والهياكل الخارجية، والتحكم عن بعد بكامل الجسم - وهي فئة البيانات الأسرع نموًا في عام 2026.
بيانات استشعار متعددة الوسائط وبيانات اصطناعية
الرؤية وحدها غير كافية. تجمع مجموعات بيانات التلاعب الحديثة بين قراءات اللمس، واستشعار القوة والعزم، والصوت، والعمق، والإحساس بالوضع. وتُعزز البيانات الاصطناعية من أجهزة المحاكاة عملية الالتقاط الحقيقية في السيناريوهات الخطرة أو النادرة أو ذات الأشكال الهندسية المتطرفة.
البيانات المُجمعة من مصادر جماعية مقابل البيانات المُجمعة في الموقع: كيف يتم جمع بيانات معالجة الروبوتات فعلياً؟
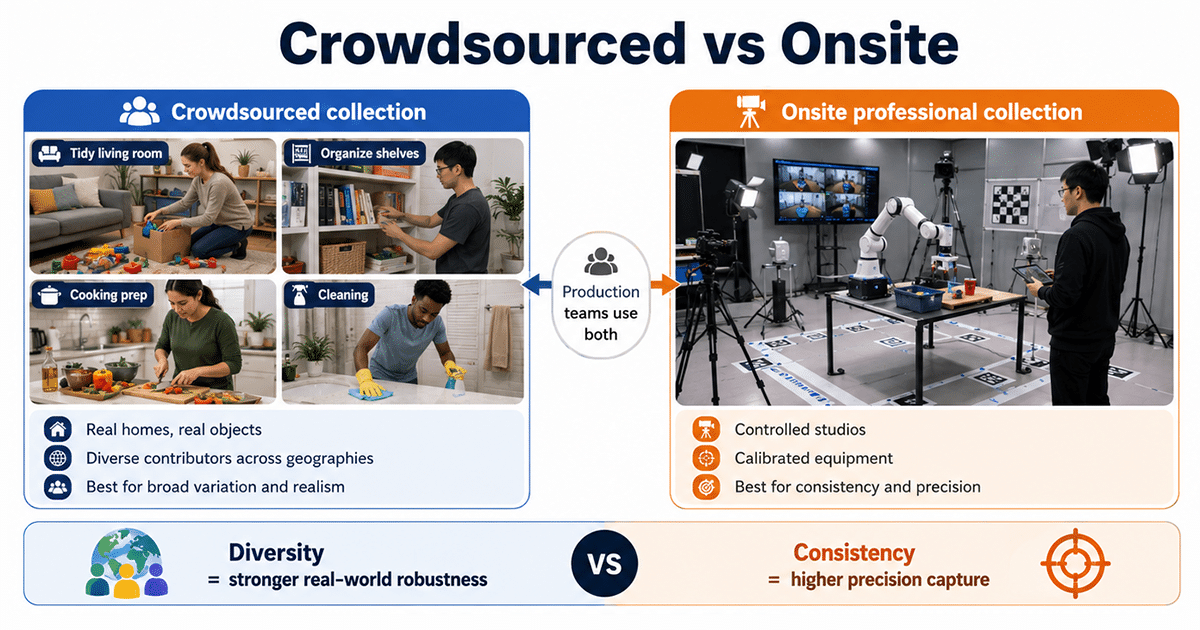
ينقسم جمع بيانات معالجة الروبوت إلى طريقتين متكاملتين، وتستخدم فرق الإنتاج كلتيهما.
تستقطب هذه المجموعة الجماعية مساهمين من مختلف المناطق الجغرافية والفئات السكانية لأداء مهام مألوفة - كالتنظيف والترتيب والطبخ - في منازلهم وباستخدام أدواتهم الخاصة. التعليمات هي "سجل نفسك وأنت ترتب غرفة معيشتك"، وليس "نفذ التسلسل 4ب". قد لا تكون النتائج مثالية، لكنها تمثل الواقع. التنوع هو المؤشر، وهو ما يساعد السياسات على الصمود أمام الواقع.
يتم جمع البيانات الاحترافية في الموقع ضمن استوديوهات مُجهزة أو بيئات محاكاة باستخدام معدات مُعايرة وفريق عمل مُدرّب. تُثبّت المتغيرات: الإضاءة بين 10 و4,000 لوكس، ومسافات الكاميرا من 3 إلى 20 قدمًا، واتجاهات الوجه المُحددة، ووتيرة العمل المُبرمجة. هذا التوازن مقصود - التخلي عن عنصر المفاجأة لتحقيق الاتساق حيث تكون الفروقات الدقيقة مهمة.
تخيل فريقًا من الروبوتات في مستودع متوسط الحجم يعمل على وضع سياسة لاختيار المنتجات من الصناديق على الرفوف المزدحمة. تغطي مجموعات البيانات العامة أسطح الطاولات النظيفة. يواجه الإنتاج تحديات مثل التغليف بالبلاستيك، والإضاءة المتفاوتة، و4,000 وحدة تخزين.
تعمل عمليات جمع البيانات الفيزيائية للذكاء الاصطناعي من Shaip على سد تلك الفجوة من خلال الجمع بين الشمولية الديموغرافية التي يتم الحصول عليها من مصادر جماعية والتقاط البيانات بدقة في الموقع - وهو المزيج الدقيق الذي لا تستطيع المجموعات العامة وحدها تقديمه.
كيف يتم تصنيف مجموعات بيانات معالجة الروبوتات؟
لا تُعتبر لقطات التحكم عن بُعد الخام بيانات تدريبية إلا بعد تصنيفها. وتُهيمن ثلاث طرق للتصنيف على مسارات عمل الروبوتات.
تسمية تسلسل الحركة المتوقفة
تستخرج تقنية تصنيف تسلسل الحركة المتوقفة الإطارات على فترات زمنية محددة، وتُصنّف كل إطار منها بمربعات محيطة، وتصنيفات هرمية، وحالات الكائنات. هكذا تتعلم النماذج أن اليد على وشك الإمساك بجسم ما، أو أنها تمسكه بالفعل. تُستخدم هذه التقنية بكثرة في الإدراك، واكتشاف حالات التلاعب، وشرح سحابة النقاط بتقنية LiDAR، حيث تُعدّ الهندسة ثلاثية الأبعاد مهمة.
شرح الفيديو الزمني
تُحدد التعليقات الزمنية بداية ونهاية كل حدث في اللقطات المتصلة، مصحوبةً بأوصاف سياقية. يُنتج مقطع فيديو منزلي مدته دقيقتان جدولًا زمنيًا منظمًا: من 00:00 إلى 00:15 قراءة، ومن 00:15 إلى 00:28 مداعبة القطة، ومن 00:28 إلى 01:54 قراءة مرة أخرى. تُستخدم هذه المخرجات لتدريب نماذج التعرف على الأنشطة وتقسيم المهام.
تقييم تنفيذ المهام
تقييم تنفيذ المهام: يتم تقييم العروض التوضيحية المسجلة وفقًا لمعايير نجاح محددة مسبقًا، مما يُمكّن الفرق من تحديد أمثلة التدريب عالية الجودة وأنماط الفشل المتكررة. تُقيّم كل خطوة في العرض التوضيحي من حيث النجاح والفائدة والملاحظات - مثل التقاط الملعقة (✓)، ووضعها في الدرج الصحيح (✓)، وإسقاط الشوكة (✗). تُجمع هذه النتائج عبر آلاف الحلقات، وتُستخدم في تصميم نماذج المكافآت والمناهج الدراسية للتعلم المعزز.
تطبق سير عمل Shaip للتعليقات التوضيحية الطرق الثلاث جميعها من خلال مسارات مراجعة متعددة المراحل، حيث تستهدف كل مرحلة بُعدًا مختلفًا للجودة - الدقة المكانية، أو الاتساق الزمني، أو معايير نجاح المهمة - اعتمادًا على أهداف النموذج.
لماذا يحتاج الذكاء الاصطناعي في مجال الروبوتات إلى ضمان الجودة من خلال تدخل بشري؟
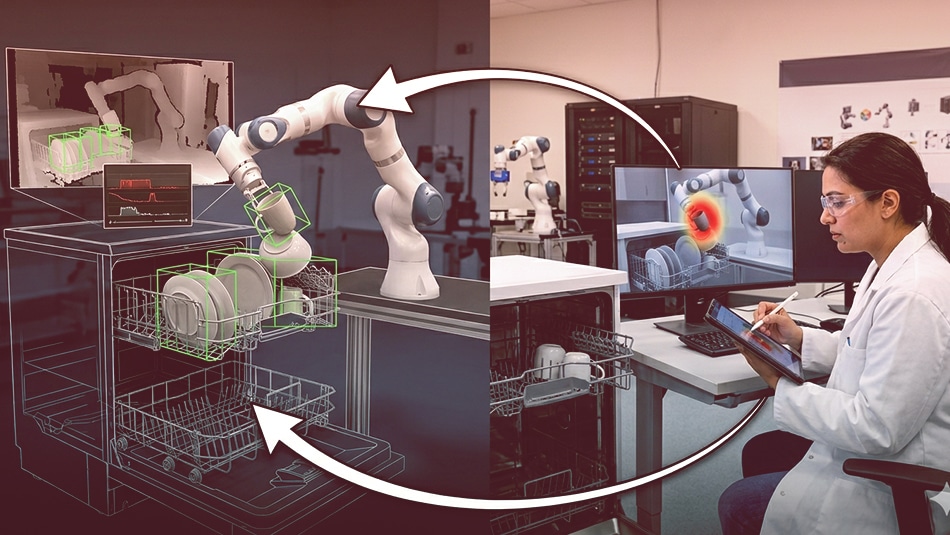
تختلف مسارات بيانات الروبوتات اختلافًا كبيرًا عن مسارات بيانات التعلم الآلي. تتم عملية إضافة التعليقات النصية بالتوازي بسلاسة عبر آلاف العاملين عن بُعد، بينما لا يمكن لتعليقات الروبوتات القيام بذلك. يحتاج الشخص الذي يُضيف تعليقات على فيديو تحميل غسالة الصحون إلى حدس فيزيائي لتحديد ما إذا كان وضع الطبق ثابتًا أم غير مستقر - إذ لا يكفي مطابقة الأنماط وحدها لاكتشاف ذلك. يُضيف تباين المستشعرات، وعدم القدرة على التنبؤ البشري، وقوانين الفيزياء في العالم الحقيقي تشويشًا لا يمكن حله إلا من قِبل مُعلّقين مُلمين بالمجال. جمعت مبادرة Open X-Embodiment أكثر من مليون مسار لروبوتات حقيقية تغطي 22 نموذجًا عبر 34 مختبرًا بحثيًا (Open X-Embodiment Collaboration، 2024) - وحتى على هذا النطاق، تظل الرقابة البشرية ضرورية للسلامة، والحالات الاستثنائية، والأحكام الذاتية حول نجاح المهمة.
[اقرأ أيضًا: كيفية إضافة التعليقات التوضيحية إلى بيانات الروبوتات ]
كيف تُعيد نماذج VLA تشكيل بيانات تدريب الروبوت التي تحتاجها؟
نموذج الرؤية-اللغة-الفعل (VLA): نموذج أساسي يربط المدخلات البصرية وتعليمات اللغة الطبيعية مباشرة بأوامر عمل الروبوت، ليحل محل وحدات الإدراك والتخطيط والتحكم المدربة بشكل منفصل.
تُغيّر نماذج VLA متطلبات البيانات بثلاث طرق. فهي تحتاج إلى شروح لغوية لكل حلقة، وليس فقط تسميات الأفعال. كما أنها تُفضّل تنوّع مجموعة البيانات على حجمها الخام - فقد قدّم مشروع DROID 76,000 مسارًا عبر 564 مشهدًا و86 مهمة، وكان التنوّع (وليس الحجم) هو العامل المُحفّز لتحسين التعميم (مشروع DROID، 2024). وتستفيد هذه النماذج أيضًا من تجميع البيانات بين الروبوتات المختلفة، بحيث يمكن استخدام البيانات المُجمّعة على روبوت واحد لتدريب سياسات روبوت آخر. أصبحت كيفية تنظيم بيانات التلاعب وتصنيفها الآن بنفس أهمية حجم البيانات التي يتم جمعها.
التصنيع مقابل الشراء: متى يجب الاستعانة بمصادر خارجية لجمع بيانات تدريب الروبوت؟
فكّر في بيانات تدريب الروبوتات كما تفكّر شركات أشباه الموصلات في مصانعها. تصميم الشريحة الإلكترونية هو الملكية الفكرية الأساسية، أما امتلاك المصنع فهو عمل مختلف تمامًا، يتطلب رأس مال ضخمًا وعمليات مكثفة، ونادرًا ما يكون مجديًا إلا إذا كان جمع البيانات هو المنتج الأساسي. لذا، ينبغي لمعظم فرق الروبوتات أن تتولى مسؤولية السياسة وتستعين بمصادر خارجية لإدارة بنية البيانات.
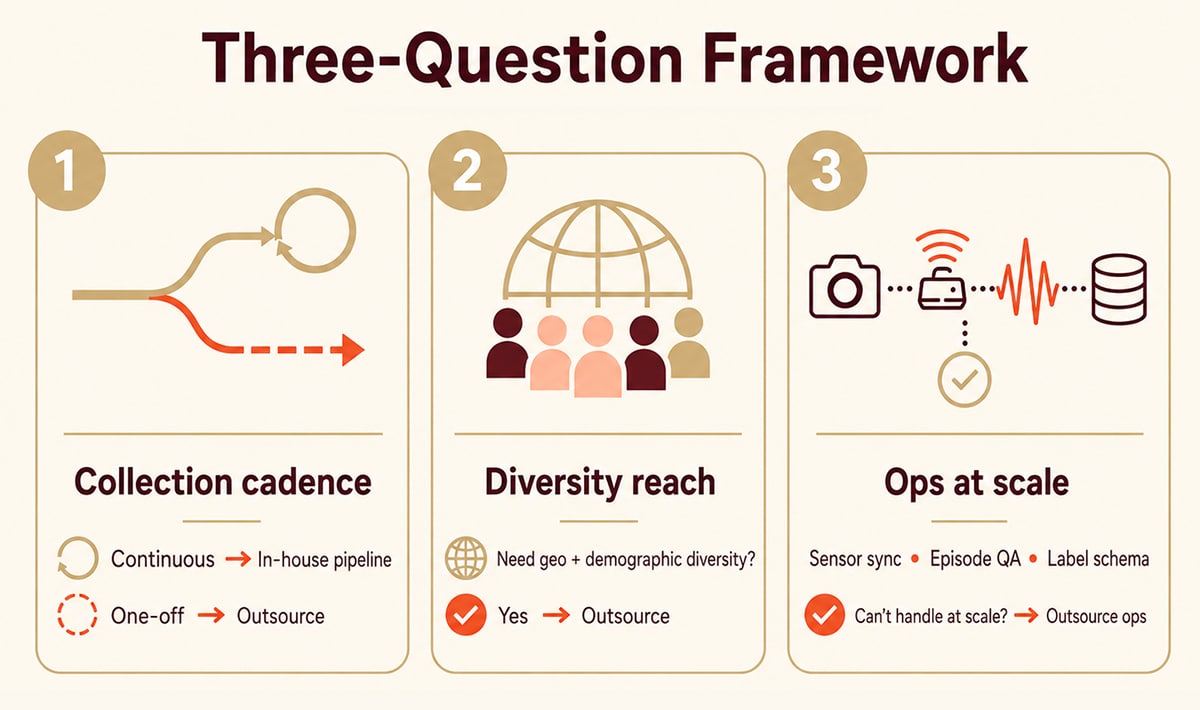
إطار عمل بسيط من ثلاثة أسئلة:
- هل عملية الجمع لمرة واحدة أم مستمرة؟ مستمر = بناء خطوط أنابيب داخلية؛ لمرة واحدة = الاستعانة بمصادر خارجية.
- هل تحتاج إلى تنوع جغرافي وديموغرافي لا يمكنك توفيره داخلياً؟ إذا كانت الإجابة بنعم، فاستعن بمصادر خارجية.
- هل يستطيع فريقك التعامل مع مزامنة أجهزة الاستشعار متعددة الوسائط، وضمان الجودة على مستوى الحلقة، ومخططات التصنيف المتسقة على نطاق واسع؟ وإلا، فقم بتعهيد العمليات إلى جهة خارجية واحتفظ بعمل السياسات داخل الشركة.
تستعين شركة Shaip بمتطوعين بشريين من أكثر من 60 دولة، مما يوفر مجموعات بيانات للتلاعب لا يمكن لمجموعات البيانات المختبرية وحدها أن تضاهيها من حيث التنوع الديموغرافي والبيئي. يجب على الشركاء الذين يتعاملون مع المتطوعين البشريين والبيئات الحقيقية وأجهزة العملاء الخاصة العمل وفقًا لضوابط أمنية مؤسسية - معيار ISO 27001 لأمن المعلومات، ومعيار SOC 2 لضوابط مزودي الخدمات، ومعيار GDPR لعروض التجارب على البشر.
خاتمة
تُشكّل بيانات تدريب الروبوتات ومجموعات بيانات التلاعب بها حجر الزاوية في أي عملية نشر روبوتات ناجحة. لن تمتلك الفرق الفائزة في عام 2026 أكبر النماذج، بل ستمتلك بيانات متنوعة ومنظمة وغنية بالمستشعرات، تم جمعها في ظروف التشغيل التي ستواجهها روبوتاتها فعليًا. سواءً أنشأتَ هذه البنية التحتية داخليًا أو تعاونتَ مع متخصص في البيانات، فإن الإطار العام يبقى ثابتًا: اجمع بين التنوع المُستقى من مصادر متعددة والدقة الميدانية، وقم بالتعليق على مستوى الإطار والحدث ونجاح المهمة، وأبقِ العنصر البشري حاضرًا حيثما يكون للحكم العملي أهمية.