تقدير الوضعية هو مهمة رؤية حاسوبية تتمثل في تحديد النقاط الرئيسية للجسم - كالمفاصل ومعالم الوجه - وربطها بهيكل عظمي يصف وضعية الشخص أو الجسم وحركته. بالنسبة للذكاء الاصطناعي الفيزيائي، تُعد بيانات حركة الهيكل العظمي هذه بمثابة الجسر الذي يحول الحركة البشرية المرصودة إلى حركات يمكن للروبوت محاكاتها وتنفيذها.
هذه الجملة الأخيرة هي التي حوّلت انتباه الصناعة بهدوء. فعلى مدى عقد من الزمان، اقتصر استخدام تقدير وضعية الجسم على تطبيقات اللياقة البدنية والبث الرياضي - مفيد، ولكنه محدود. أما الآن، فقد أصبحت نفس النقاط الرئيسية والهياكل الأساسية إشارة تدريب أساسية للروبوتات الشبيهة بالبشر، والأنظمة المستقلة، ونماذج الرؤية واللغة والحركة. فعندما يتعلم الروبوت سكب شيء ما، أو تكديسه، أو فرزه، أو مناولته لشخص ما، فإن جزءًا كبيرًا مما تعلمه جاء من مشاهدة كيفية قيام البشر بذلك أولًا - وهذه المشاهدة هي بيانات وضعية الجسم.
ما الذي يلتقطه تقدير الوضعية فعلياً
تعتمد تقنية تقدير الوضعية بشكل أساسي على تحديد مجموعة من النقاط الرئيسية - معالم تشريحية مثل الكتفين والمرفقين والمعصمين والوركين والركبتين والكاحلين، بالإضافة إلى نقاط الوجه مثل العينين والأنف والأذنين - وربطها بهيكل عظمي يمثل الوضعية والحركة. بتتبع هذا الهيكل العظمي عبر الإطارات، ستحصل على وصف موجز وقابل للقراءة آليًا لكيفية تحرك الجسم مع مرور الوقت.
ينقسم هذا المجال إلى عدة فروع مألوفة. يركز تقدير وضعية الجسم البشري على الأشخاص، بينما تُطبّق التقنيات نفسها على الحيوانات والأشياء. يمكن أن يكون الكشف ثنائي الأبعاد (تحديد النقاط الرئيسية كإحداثيات بكسل س، ص) أو ثلاثي الأبعاد (إضافة العمق، ع، للحصول على هيكل مكاني حقيقي). توجد خيارات أخرى على مستوى طبقة النموذج - مثل الكشف عن شخص واحد أو عدة أشخاص - لكن هذه قرارات معمارية تخص فريق تصميم النموذج، وليست خصائص لبيانات التدريب. ما يحدد نجاح نموذج الوضعية ليس استراتيجية الكشف، بل دقة واتساق وتغطية النقاط الرئيسية التي تعلمها. هذه مشكلة بيانات، وهي الجانب الذي تُقلل الفرق من شأنه.
لماذا تُعد بيانات الوضعية حلقة مفقودة في الذكاء الاصطناعي الفيزيائي؟
يتعين على نظام الذكاء الاصطناعي المادي إكمال حلقة لا يقوم بها برنامج الدردشة الآلي أبدًا: إدراك العالم، واتخاذ القرار، ثم التصرف بناءً عليه فعليًا. لقد تطورت قدرة الإدراك لدى الروبوتات - فهي قادرة على الرؤية. يكمن التحدي في ربط ما تراه الروبوتات بحركة منسقة وصحيحة فيزيائيًا، وتُعد بيانات الوضعية والحركة هي الأساس الذي تقوم عليه هذه الحركة.
لنتأمل كيف تكتسب أنظمة تعلم الروبوتات الحديثة المهارات. فالعروض التوضيحية الحقيقية للروبوتات، التي تُسجل عن بُعد، دقيقة، لكنها بطيئة ومكلفة في جمع البيانات. لذا، تتجه الفرق بشكل متزايد إلى التدريب المسبق على مصدر أكثر وفرة: مقاطع فيديو لبشر يؤدون مهامًا. وقد أظهرت أبحاث الروبوتات الحديثة أن السياسات المدربة مسبقًا على مقاطع فيديو بشرية واسعة النطاق من منظور الشخص الأول يمكن أن تعمم بشكل أفضل من تلك المدربة على بيانات الروبوتات وحدها، لأن مقاطع الفيديو البشرية تحمل التنوع والفيزياء وبنية المهام التي لا تستطيع بيانات الروبوتات التي تُجمع في المختبرات محاكاتها على نطاق واسع.
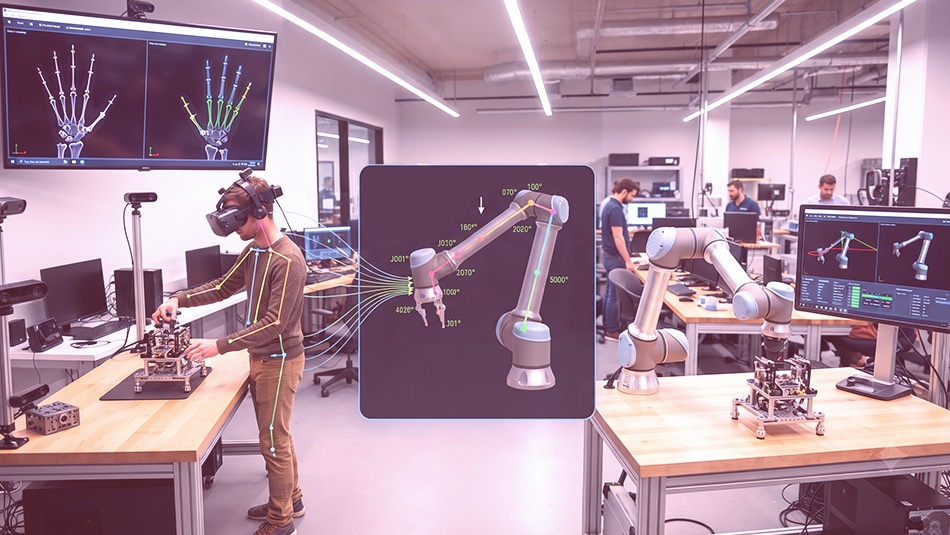
لكن الفيديو البشري الخام لا يمكن استخدامه مباشرةً من قِبل الروبوت. فالروبوت لا يمتلك جسماً مطابقاً لجسم الإنسان؛ بل يمتلك مفاصله الخاصة، وأذرعه، ودرجات حريته. ويُعدّ تقدير الوضعية بمثابة طبقة الترجمة. فمن خلال اختزال عرض الإنسان إلى هيكل عظمي مُهيكل - وبالأخص هيكل اليد - يُمكن إعادة توجيه تلك الحركة إلى حركية الروبوت وتحويلها إلى مسارات حركة يُمكن تدريب السياسة عليها. وهذا تحديداً هو المُدخل الذي تتوق إليه نماذج الرؤية-اللغة-الحركة (VLA) .
تظهر بيانات الوضعية في جميع أنحاء بنية الذكاء الاصطناعي الفيزيائي بثلاثة أشكال متكررة: وضعية المشغل الملتقطة أثناء التشغيل عن بُعد، ووضعية العامل للروبوتات التعاونية التي يجب أن تتشارك المساحة بأمان مع البشر، ووضعية العرض التوضيحي البشري المستخرجة من فيديو من منظور الشخص الأول والمُعاد توجيهها إلى حركة الروبوت. في كل حالة، تحدد جودة الهيكل العظمي الحد الأقصى لجودة الحركة التي يمكن للروبوت تعلمها.
من التقاط الحركة إلى حركة الروبوت
غالبًا ما يتم الربط بين حركة الإنسان وحركة الروبوت عبر تقنيات نمذجة الجسم ثلاثية الأبعاد البارامترية، التي تُطابق الجسم بالكامل - بما في ذلك اليدين - مع نقاط رئيسية مُقدَّرة، مما يُنتج حركة متناسقة فيزيائيًا من فيديو عادي. وهذا في جوهره ما يُعرف بالتقاط الحركة بدون علامات. في مجال الروبوتات، يُصبح الجسم المُطابق مصدرًا لمسارات حركة دقيقة: الوصول، والإمساك، والرفع، والوضع، والإفلات، حيث تُقسَّم كل مرحلة وتُؤقَّط زمنيًا. وكلما كانت بيانات وضعية الجسم الأساسية أفضل، كان مسار الحركة المُعاد توجيهه أكثر دقة.
الوضعية ثنائية الأبعاد مقابل الوضعية ثلاثية الأبعاد - أيهما يحتاجه الروبوت الخاص بك فعلاً؟
هذا هو السؤال الذي تطرحه فرق الروبوتات في أغلب الأحيان، والإجابة الصادقة هي: يعتمد ذلك على ما علاقة الروبوت بالوضعية.
يُتيح لك تقدير الوضعية ثنائية الأبعاد تحديد نقاط رئيسية على مستوى الصورة. وهذا كافٍ للتحقق من الشكل، والتعرف على الإيماءات، وتصنيف الأنشطة، كما أنه أقل تكلفة في التقاط الصور وأسرع في إضافة التعليقات التوضيحية. لكنه لا يُمكنه تحديد بُعد اليد عن الكوب، أو الزاوية الحقيقية للمفصل في الفضاء.
تُضيف تقنية تقدير الوضعية ثلاثية الأبعاد محور العمق، مما يُنتج هيكلاً مترياً مُحدداً في ثلاثة أبعاد. في عمليات المناولة - كالمسك والوضع والمهام التي تتطلب تلامساً مكثفاً - يُعدّ هذا الأمر ضرورياً للغاية، لأن نقاط المسك وزوايا المفاصل تحتاج إلى دقة مترية بمجرد أن يلمس الروبوت شيئاً ما. عادةً ما تُستعاد الوضعية ثلاثية الأبعاد باستخدام كاميرات ستيريو أو كاميرات عمق، أو تقنية LiDAR، أو أنظمة متعددة الكاميرات، أو تقنية تحويل ثنائي الأبعاد إلى ثلاثي الأبعاد، وتتطلب هذه التقنية تكلفة أعلى في كلٍ من عملية الالتقاط والتعليق.
القاعدة التي نقدمها للعملاء: إذا كان نظامك يحتاج فقط إلى فهم الحركة، فقد يكون ثنائي الأبعاد كافيًا؛ أما إذا كان عليه إعادة إنتاج الحركة في العالم المادي، فخطط لثلاثي الأبعاد - وصمم مجموعة المستشعرات ومخطط التعليقات التوضيحية بناءً على ذلك منذ اليوم الأول، وليس بعد أول محاولة فاشلة.
وضعية اليد والمهارة
إذا كانت وضعية الجسم تُساعد الروبوت على الوصول إلى الجسم المطلوب، فإن وضعية اليد تُمكّنه من الوصول إليه بنجاح. تعتمد المناورة الدقيقة على تتبع دقيق لمفاصل الأصابع ونقاط التلامس وتكوين القبضة - غالبًا ما يصل إلى عشرين نقطة رئيسية أو أكثر لكل يد. هذا هو الجانب الذي يُمثل عائقًا كبيرًا أمام الذكاء الاصطناعي الفيزيائي حاليًا، وهو أيضًا الجانب الذي يتطلب أعلى معايير التوصيف. لقد أثبتت بيانات الفيديو ووضعية اليد المُقترنة فعاليتها في تعليم المناورة؛ إلا أن إنتاجها بشكل موثوق وبكميات كبيرة يُعد تخصصًا دقيقًا.
مواضع انقطاع بيانات الوضعية
تفشل نماذج الوضعيات بطرق يمكن التنبؤ بها، ويعود السبب في معظمها إلى بيانات التدريب وليس إلى بنية النظام:
- انسداد. تختبئ الأطراف خلف الجذوع، وتختفي الأيدي خلف الأشياء، وتخرج الشخصيات من إطار الصورة. سواء أشرت إلى النقاط الرئيسية المخفية بصدق أم خمنتها، فإن الشكل يمثل موثوقية النموذج.
- تداخل بين عدة أشخاص. عندما تتقاطع الأجسام، يتم تبديل أو دمج النقاط الرئيسية، لذا فإن تتبع الهوية المنضبط أمر بالغ الأهمية.
- اختلاف زاوية الرؤية والإضاءة والملابس. النموذج الذي يتم تدريبه فقط على إطارات نظيفة، أمامية، ومضاءة جيداً ينهار في العالم الحقيقي.
- غموض العمق. بالنسبة للوضع ثلاثي الأبعاد، فإن استنتاج العمق من مناظر محدودة أمر صعب بطبيعته ويتطلب شرحًا متسقًا لتجنب تعليم هندسة خاطئة.
- حركة ديناميكية. تؤدي الحركة السريعة إلى ضبابية وانحراف من إطار إلى آخر؛ يجب أن تظل النقاط الرئيسية ثابتة عبر الزمن، وليس فقط صحيحة في الإطارات الفردية.
- التناسق التشريحي. إن وضع علامة على المعصم في إطار واحد وعلى منتصف الساعد في الإطار التالي يؤدي بهدوء إلى تسميم مجموعة البيانات.
الفكرة الأساسية: يرث نموذج الوضعية كل تناقض في نقاطه الرئيسية، وفي الذكاء الاصطناعي الفيزيائي، تتحول هذه التناقضات إلى حركات خاطئة، بل وخطيرة أحيانًا. إن دقة عملية إضافة التعليقات التوضيحية لا تقل أهمية عن حجم البيانات الخام.
داخل مسار عمل وضعيات التصوير الواقعية: مشروع شايب المكون من 150,000 إطار مع نقاط رئيسية
قام شايب، لصالح أحد عملاء مجال رؤية الحاسوب، بتصنيف 150,000 إطار من الصور والفيديوهات باستخدام مخطط مخصص مكون من 36 نقطة رئيسية - معالم الوجه بالإضافة إلى هيكل عظمي كامل للجسم - مصمم لدعم كل من تقدير الوضعية وتحليل حركة الوجه في خطوة واحدة. شمل العمل أوضاعًا وزوايا وإضاءة وملابس متنوعة، مع معالجة دقيقة للحجب (تحديد المعالم المخفية، وعدم تخمينها أبدًا)، واجتياز كل إطار لاختبارات ضمان الجودة المنظمة وفقًا لمعيار دقة مُعاير. وكانت النتيجة خط إنتاج جاهز للاستخدام يدعم نماذج العميل الخاصة بالوضعية والحركة واللياقة البدنية وحركة الرعاية الصحية. التفاصيل الكاملة موجودة في دراسة حالة تصنيف نقاط الجسم البشري الرئيسية.
الخلاصة: لقد درّب هذا المشروع نموذجًا لحركة الإنسان ، لكنّ الانضباط الذي تطلّبه - مخطط بيانات مخصص كثيف، ومعالجة دقيقة للحجب، وتنوّع في وضعيات الجسم على نطاق واسع - هو نفسه الانضباط الذي تتطلّبه سياسة الروبوتات الشبيهة بالبشر أو الروبوتات التعاونية. يتغيّر التطبيق، لكن معيار البيانات يبقى ثابتًا.
حالات استخدام تقدير الوضعية: تطبيقات عملية
تُستخدم بيانات الوضعية والحركة الآن لتدريب أنظمة تتجاوز مجال الروبوتات، حيث يحدد كل مجال منها مخطط النقاط الرئيسية ومعايير الدقة الخاصة به. بالنسبة لفرق الذكاء الاصطناعي الفيزيائي، تكمن الفائدة في أن هذه البيانات تمثل مصادر متداخلة لنفس الأصل - بيانات حركة بشرية عالية الدقة يمكن توجيهها نحو الذكاء المجسد.
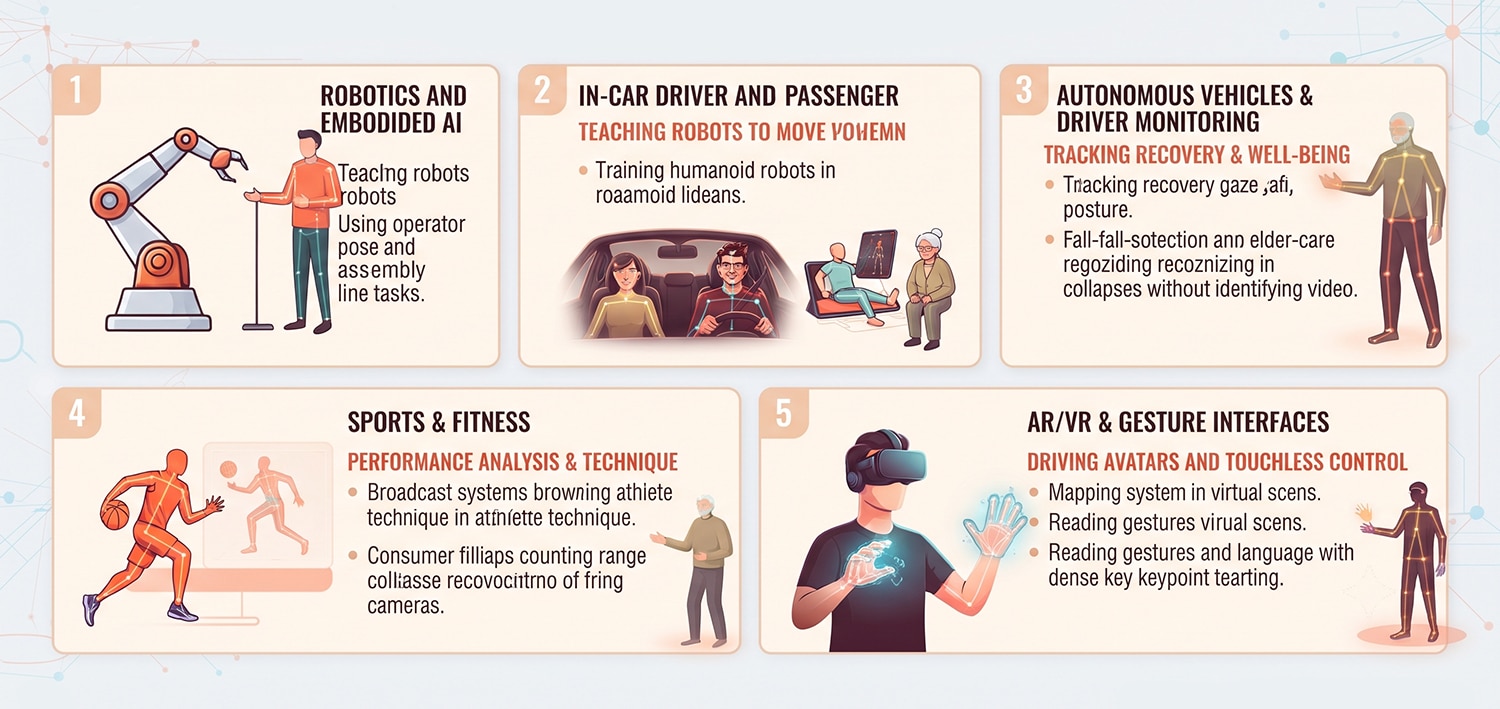
الروبوتات والذكاء الاصطناعي المُجسّد - آفاق جديدة. تُعلّم بيانات وضعية الجسم الروبوتات الحركة من خلال التعلّم من سلوك الإنسان. على سبيل المثال، يتم تدريب روبوت بشري مُصمّم للعمل في المستودعات، والذي يتعلم رفع الصناديق ووضعها على سير ناقل، جزئيًا باستخدام فيديوهات مُتتبعة لوضعية الجسم لأشخاص يؤدون المهمة نفسها، بينما تُوفّر وضعية جسم المُشغّل من جلسات التشغيل عن بُعد مسارات الحركة الدقيقة. في خطوط التجميع، تستخدم الروبوتات التعاونية وضعية جسم العامل في الوقت الفعلي للحفاظ على مسافة آمنة وتسليم الأجزاء دون تصادمات - وهو نوع من مهام مناولة الصناديق والمهام الجانبية لخطوط الإنتاج التي يتم تجريبها حاليًا في مصانع الخدمات اللوجستية والسيارات.
المركبات ذاتية القيادة ومراقبة السائق. داخل المقصورة، يتتبع نظام تقدير الوضعية وضعية رأس السائق ونظره ووضعية الجزء العلوي من جسمه للكشف عن النعاس أو تشتت الانتباه. وتعتمد أنظمة مراقبة السائق المُستخدمة في المركبات الجديدة لتلبية متطلبات تصنيف السلامة لبرنامج تقييم السيارات الأوروبي الجديدة (Euro NCAP) لعام 2026 على بيانات معالم الوجه والنقاط الرئيسية هذه تحديدًا.
الرعاية الصحية والتأهيل. يقيس تقدير وضعية الجسم كيفية تحركه فعليًا، وهو ما يستخدمه الأطباء لمتابعة التعافي. يمكن لتطبيق العلاج الطبيعي مراقبة المريض أثناء التمرين عبر كاميرا الهاتف، وحساب مدى الحركة، وتحديد الوضعيات غير الصحيحة؛ كما يمكن لنظام كشف السقوط في مرافق رعاية المسنين التعرف على الانهيار من خلال حركة الهيكل العظمي فقط، دون الحاجة إلى تخزين مقاطع فيديو تعريفية.
الرياضة واللياقة البدنية. يحوّل تتبع الهيكل العظمي مقاطع الفيديو العادية إلى بيانات أداء. تقوم أنظمة البث بتراكب هياكل عظمية في الوقت الفعلي على الرياضيين لتحليل التقنية، بينما تقوم تطبيقات اللياقة البدنية الاستهلاكية بحساب التكرارات وتصحيح الوضعية باستخدام كاميرا الهاتف فقط.
واجهات الواقع المعزز/الواقع الافتراضي والإيماءات. تُحرك وضعية الجسم واليد الصور الرمزية وتُمكّن التحكم بدون لمس. يعتمد جهاز الرأس الذي يرسم يديك في مشهد افتراضي، أو الواجهة التي تقرأ الإيماءات ولغة الإشارة، على تتبع دقيق لنقاط اليد الرئيسية في ظل حجب ذاتي كبير.
اختيار شريك بيانات الوضعية والنقاط الرئيسية
إذا كنت بصدد تقييم الجهة التي يجب أن تقوم بإنشاء بيانات الوضعية الخاصة بك، فإن الأسئلة التي تفصل بين البائعين هي أسئلة تشغيلية وليست تجميلية: