تُستخدم تقنية التعرف الضوئي على الأحرف (OCR) الآن في مسح الإيصالات، والتحقق من الهوية، وأتمتة الفواتير، ورقمنة الأرشيفات التاريخية، وتطبيقات تدوين الملاحظات باستخدام القلم. من المتوقع أن يصل حجم سوق OCR إلى 32.90 مليار دولار أمريكي بحلول عام 2030 بمعدل نمو سنوي مركب قدره 14.8% (بحسب Grand View Research، 2024)، مع نمو تقنية التعرف الذكي على الأحرف - فرع قراءة الكتابة اليدوية من OCR - بوتيرة أسرع. سواءً كنت تُطوّر نظامًا لتحليل المستندات، أو اكتشاف النصوص في المشاهد، أو نسخ الكتابة اليدوية، فإن مجموعة بيانات OCR التي تُدرّب عليها تُحدّد مستوى دقة النظام. يُغطي هذا الدليل 22 مجموعة بيانات OCR مجانية ومفتوحة المصدر - بما في ذلك أفضل مجموعات بيانات الكتابة اليدوية - مُصنّفة حسب حالة الاستخدام ومُحدّثة بأحدث الإصدارات حتى عام 2024.
الوجبات السريعة الرئيسية
- التعرف الضوئي على الحروف (التعرف الضوئي على الحروف): تقنية تحول صور النصوص المطبوعة أو المشاهد أو النصوص المكتوبة بخط اليد إلى بيانات قابلة للقراءة آلياً.
- تنقسم مجموعات بيانات التعرف الضوئي على الحروف إلى خمس مجموعات: المستند/النموذج، نص المشهد، الرقم/الحرف، الكتابة اليدوية، ومتعدد اللغات.
- مجموعات بيانات التعرف الضوئي على الأحرف للمستندات التقاط الصفحات المنظمة مثل النماذج والإيصالات؛ مجموعات بيانات نص المشهد التقاط النص "في البرية".
- لا تزال معايير IAM وMNIST وICDAR وSROIE هي المعايير الأكثر استشهادًا بها في مجال التعرف الضوئي على الأحرف (OCR) في جميع الأبحاث.
- تختلف شروط الترخيص اختلافًا كبيرًا - تحقق من كل مجموعة بيانات OCR قبل التدريب التجاري.
ما هو التعرف الضوئي على الحروف (OCR)؟
التعرف الضوئي على الحروف (OCR) هي تقنية تعمل على تحويل أنواع مختلفة من المستندات، مثل المستندات الورقية الممسوحة ضوئيًا أو ملفات PDF أو صور النصوص، إلى بيانات قابلة للتحرير والبحث. وتعمل هذه التقنية من خلال:
- تحليل بنية النص في الصورة
- تقسيم النص إلى أسطر وأحرف
- تحويل هذه الأحرف المرئية إلى نص يمكن قراءته بواسطة الآلة
تشمل الاستخدامات الشائعة ما يلي:
- تحويل المستندات الممسوحة ضوئيًا إلى ملفات نصية قابلة للتحرير
- رقمنة الكتب المطبوعة
- استخراج النص من الصور
- تحويل الوصفات الطبية المكتوبة بخط اليد إلى نص رقمي
- التعرف على لوحة الترخيص
كيف تختار مجموعة بيانات التعرف الضوئي على الأحرف (OCR) المناسبة؟
يعتمد اختيار مجموعة بيانات التعرف الضوئي على الحروف (OCR) على أربعة عوامل: نوع النص، وبيئة الالتقاط، ودقة التعليقات التوضيحية، والترخيص. يحتاج التعرف الضوئي على الحروف للمستندات المطبوعة إلى بيانات تدريب مختلفة عن تلك المستخدمة في النصوص المكتوبة بخط اليد أو النصوص المنحنية. تناسب مجموعات بيانات المستندات الفواتير والنماذج والإيصالات؛ بينما تناسب مجموعات بيانات النصوص المنحنية اللافتات وقراءة المنتجات؛ أما مجموعات بيانات الكتابة اليدوية فتناسب الملاحظات والمخطوطات والكتابة بالقلم. تدعم التعليقات التوضيحية على مستوى الكلمة والسطر مسارات التعرف الضوئي على الحروف الكاملة، في حين أن مجموعات التعليقات التوضيحية على مستوى الحرف تناسب خطوط الأساس للتصنيف. تأكد دائمًا من شروط الترخيص، حيث أن بعض مجموعات بيانات التعرف الضوئي على الحروف مخصصة للأبحاث فقط أو تتطلب التسجيل.
ما هي أفضل مجموعات بيانات التعرف الضوئي على الأحرف (OCR) للمستندات والنماذج؟
تُستخدم مجموعات بيانات التعرف الضوئي على الأحرف (OCR) لتدريب نماذج تحليل الصفحات المنظمة مثل الفواتير والنماذج والإيصالات وبطاقات الهوية. وتُسهم هذه المجموعات في أتمتة مستندات الأعمال واستخراج القيم الرئيسية.
- متعة — ١٩٩ نموذجًا ممسوحًا ضوئيًا مع تعليقات توضيحية، ذات مظهر واقعي مشوش. المعيار القياسي لفهم النماذج واستخراج القيم الرئيسية.
- سروي — مجموعة بيانات ICDAR 2019 للإيصالات الممسوحة ضوئياً والتي تضم حوالي 1,000 إيصال، وتدعم اكتشاف النصوص والتعرف عليها واستخراج المعلومات في مجموعة واحدة.
- حبل — مجموعة بيانات إيصالات موحدة مصممة للتحليل بعد التعرف الضوئي على الأحرف، مع تسميات غنية على مستوى الحقول لأتمتة الفواتير والإيصالات.
- XFUND — نسخة متعددة اللغات من FUNSD تغطي سبع لغات (الألمانية، الإسبانية، الفرنسية، الإيطالية، اليابانية، البرتغالية، الصينية) بواقع 199 صفحة لكل لغة. مثالية لتطبيقات الذكاء الاصطناعي للمستندات متعددة اللغات.
- DDI-100 — حوالي 100,000 صورة لمستندات مشوهة للكشف والتعرف عليها في ظل ظروف التدهور الواقعية مثل الانحراف والتشويش والضوضاء.
ما هي أفضل مجموعات بيانات التعرف الضوئي على الأحرف (OCR) لنصوص المشاهد؟
تُستخدم مجموعات بيانات التعرف الضوئي على الأحرف (OCR) للنصوص في المشاهد لتدريب النماذج على قراءة النصوص في الصور الطبيعية مثل اللافتات والمنتجات ومشاهد الشوارع. وتُعد هذه المجموعات ضرورية لتطبيقات التعرف الضوئي على الأحرف في البيئات الواقعية حيث تكون الخلفيات مزدحمة.
- قراءة ICDAR القوية — عائلة المعايير التي تقف وراء معظم أبحاث نص المشهد، بما في ذلك تحديات نص المشهد المركز والعرضي مع مربعات الإحاطة على مستوى الكلمات والنصوص المكتوبة.
- نص COCO — تعليقات نصية واسعة النطاق على صور MS-COCO. فعّالة في اكتشاف النصوص على نطاق واسع في المشاهد الطبيعية.
- النص الكامل — متخصص في النصوص المنحنية والموجهة بشكل عشوائي، وهي نقطة ضعف معروفة في نماذج التعرف الضوئي على الأحرف القديمة.
- نص عرض الشارع (SVT) — صور الكلمات مأخوذة من خدمة خرائط جوجل، وغالبًا ما تكون منخفضة الدقة وعالية التباين. متوفرة عبر مواقع Papers with Code البديلة.
- نص هرمي — شرح هرمي من الفقرة إلى السطر إلى الكلمة، يشمل النصوص المكتوبة بخط اليد والمطبوعة. مفيد لتقنية التعرف الضوئي على الحروف (OCR) التي تراعي تخطيط الصفحة.
ما هي أفضل مجموعات بيانات التعرف الضوئي على الأحرف والأرقام؟
تُستخدم مجموعات بيانات التعرف الضوئي على الأحرف والأرقام لتدريب النماذج على التعرف على الرموز الفردية في بيئات مضبوطة. وتُعد هذه المجموعات نقاط انطلاق قياسية لخطوط الأساس في التصنيف.
- منيست — 70,000 صورة لأرقام مكتوبة بخط اليد بتدرج الرمادي. أسرع طريقة أساسية للتحقق من صحة مصنف الأرقام.
- إمينست — توسيع قاعدة بيانات MNIST بـ 814,255 حرفًا ورقمًا مكتوبًا بخط اليد مستمدًا من قاعدة بيانات NIST الخاصة رقم 19.
- SVHN (أرقام المنازل في عرض الشارع) — أكثر من 600,000 صورة رقمية حقيقية لأرقام المنازل. خطوة عملية متقدمة عن مجموعة بيانات MNIST في الظروف الصاخبة.
- Chars74K — 74,107 صورة تغطي الأحرف الإنجليزية والكانادا من الصور الطبيعية وخطوط الكمبيوتر.
- قاعدة بيانات المعهد الوطني للمعايير والتكنولوجيا الخاصة 19 — أكثر من 810,000 صورة لأحرف مطبوعة يدويًا من 3,600 كاتب. المصدر الذي تستند إليه العديد من معايير التعرف الضوئي على الحروف الإنجليزية.
ما هي أفضل مجموعات بيانات الكتابة اليدوية لتقنية التعرف الضوئي على الحروف (OCR)؟
تُستخدم مجموعات بيانات الكتابة اليدوية لتدريب نماذج التعرف الضوئي على الحروف (OCR) على قراءة النصوص المكتوبة بخط اليد، سواءً كانت متصلة أو مطبوعة أو تاريخية. ولا تزال أقوى مجموعات بيانات الكتابة اليدوية المفتوحة هي المعايير الأكثر استخدامًا في مجال التعرف على النصوص المكتوبة بخط اليد.
- قاعدة بيانات الكتابة اليدوية IAM — المعيار الذهبي لتحليل الخط الإنجليزي، حيث يضم 13,353 سطراً نصياً من 657 كاتباً. ولا يزال هذا المعيار الأكثر استشهاداً به في أبحاث التعرف الضوئي على الحروف (OCR) لعامي 2024-2025.
- IAM-OnDB — نسخة IAM الإلكترونية التي تعتمد على حركة القلم، والتي تلتقط بيانات المسار. مجموعة بيانات الكتابة اليدوية المعيارية للتعرف على القلم واللوحة.
- أوراق بنثام — مخطوطات إنجليزية تاريخية منسوخة من أعمال الفيلسوف جيريمي بنثام. المعيار الرائد لتقنية التعرف الضوئي على الحروف في الكتابة اليدوية التاريخية، ويمكن الوصول إليه عبر برنامج Transkribus.
- GNHK (مجموعة GoodNotes للكتابة اليدوية) — مجموعة بيانات من عام 2021 تضم ملاحظات مكتوبة بخط اليد باللغة الإنجليزية من واقع الحياة اليومية. وهي أقرب إلى بيانات الإنتاج غير المنظمة منها إلى بيانات إدارة الهوية والوصول المنظمة في المختبر.
ما هي أفضل مجموعات بيانات التعرف الضوئي على الأحرف متعددة اللغات وغير اللاتينية؟
تُدرّب مجموعات بيانات التعرف الضوئي على الحروف متعددة اللغات النماذج على نصوص تتجاوز اللغة الإنجليزية، بما في ذلك الصينية والعربية والرموز الرياضية. وتُعد هذه البيانات ضرورية للتعرف على المستندات والكتابة اليدوية على مستوى العالم.
- CASIA-HWDB — المعيار القياسي الصيني للتعرف الضوئي على الأحرف، مع 1.17 مليون عينة من الأحرف المكتوبة بخط اليد من 1,020 كاتبًا.
- خات — ألف نموذج مكتوب بخط اليد باللغة العربية من ألف كاتب مختلف، تم مسحها ضوئياً بدقة متعددة. أكثر مجموعات بيانات التعرف الضوئي على الحروف العربية المفتوحة شمولاً.
- كروم — مسابقة للتعرف على التعبيرات الرياضية المكتوبة بخط اليد عبر الإنترنت: أكثر من 10,000 تعبير رياضي باستخدام أكثر من 101 رمز رياضي، في نسختين: إلكترونية وغير إلكترونية. ضرورية لتقنية التعرف الضوئي على الحروف للمعادلات المكتوبة بخط اليد.
ما هي المشاكل الشائعة عند استخدام مجموعات بيانات التعرف الضوئي على الأحرف المجانية؟
ثلاثة مآزق تقع فيها معظم الفرق.
عدم تطابق المجال: التدريب على IAM أو COCO-Text النظيف ونشره على فواتير مجعدة يضمن دقة ضعيفة.
تجاهل الترخيص: العديد من مجموعات بيانات التعرف الضوئي على الأحرف (OCR) الخاصة بالنصوص والمشاهد التاريخية مخصصة للأبحاث فقط أو تتطلب التسجيل قبل الاستخدام التجاري.
ثغرات في التعليقات التوضيحية: تفتقر العديد من مجموعات بيانات التعرف الضوئي على الأحرف (OCR) إلى بيانات تعريف التخطيط، أو مربعات الإحاطة على مستوى السطر، أو تسميات الحقول التي تحتاجها أنظمة الإنتاج.
تخيل شركة لوجستية متوسطة الحجم تُؤتمت قراءة ملصقات الشحن. يُمكّنها التدريب على النصوص العامة من الوصول إلى 80% في المعايير، لكن الملصقات الحقيقية ذات الوهج والطيات تُخفضها إلى 58%. ولتضييق هذه الفجوة، تطلّب الأمر إضافة تعليقات توضيحية مُستهدفة لبيانات 6,000 صورة لملصقات الشحن قبل الإطلاق.
فوائد وتحديات مجموعات البيانات مفتوحة المصدر
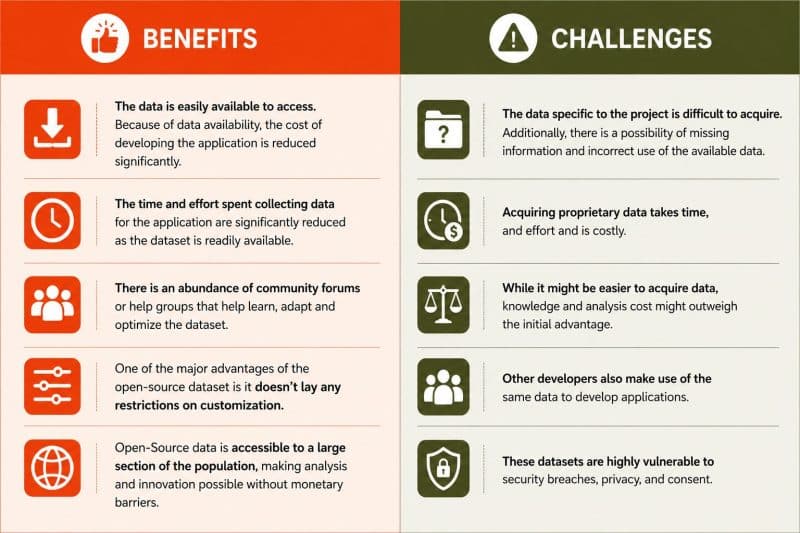
تحتاج الشركات إلى وضع الفوائد والتحديات ضد بعضها البعض لفهم ما إذا كان يجب عليها اختيار البيانات المجانية للاستخدام لتطبيقات ML الخاصة بها.
الفوائد
- البيانات متاحة بسهولة للوصول إليها. بسبب توفر البيانات ، يتم تقليل تكلفة تطوير التطبيق بشكل كبير.
- يتم تقليل الوقت والجهد المبذولين في جمع البيانات للتطبيق بشكل كبير نظرًا لأن مجموعة البيانات متاحة بسهولة.
- هناك وفرة من المنتديات المجتمعية أو مجموعات المساعدة التي تساعد في تعلم مجموعة البيانات وتكييفها وتحسينها.
- تتمثل إحدى المزايا الرئيسية لمجموعة البيانات مفتوحة المصدر في أنها لا تضع أي قيود على التخصيص.
- البيانات مفتوحة المصدر متاحة لقطاع كبير من السكان ، مما يجعل التحليل والابتكار ممكنين بدون حواجز نقدية.
التحديات
- يصعب الحصول على البيانات الخاصة بالمشروع. بالإضافة إلى ذلك ، هناك احتمال فقدان المعلومات والاستخدام غير الصحيح للبيانات المتاحة.
- يستغرق الحصول على البيانات الاحتكارية وقتًا وجهدًا مكلفًا
- في حين أنه قد يكون من الأسهل الحصول على البيانات ، إلا أن تكلفة المعرفة والتحليل قد تفوق الميزة الأولية.
- يستخدم المطورون الآخرون أيضًا نفس البيانات لتطوير التطبيقات.
- مجموعات البيانات هذه معرضة بشكل كبير للانتهاكات الأمنية والخصوصية والموافقة.
كيف يدعم تطبيق Shaip مشاريع التعرف الضوئي على الأحرف (OCR) والتعرف على الكتابة اليدوية؟
تجمع خدمات بيانات التدريب لتقنية التعرف الضوئي على الأحرف (OCR) من Shaip بين تنظيم مجموعات البيانات المفتوحة وجمع البيانات المخصصة عبر أكثر من 60 لغة، تشمل المستندات المطبوعة، والكتابات اليدوية، والإيصالات، وبطاقات الهوية. وتضيف عمليات التعليق التوضيحي من Shaip طبقات تفتقر إليها مجموعات بيانات OCR العامة: مربعات تحديد الأسطر، وتسميات الحقول، ومراقبة جودة النسخ، وبيانات تعريف الكاتب.
خاتمة
توفر لك مجموعات بيانات التعرف الضوئي على الحروف (OCR) الـ 22 المذكورة أعلاه أساسًا متكاملًا مفتوح المصدر يشمل التعرف على المستندات، ونصوص المشاهد، والأرقام، والكتابة اليدوية، واللغات المتعددة حتى عام 2026. ابدأ بمجموعة بيانات OCR التي تتوافق مع نوع النص وبيئة الالتقاط لديك، وتحقق من صحتها باستخدام عينة من بياناتك الحقيقية، وخصص ميزانية للتعليقات التوضيحية المخصصة لسد الفجوة بين المجالات. هذا المزيج أسرع من بناء النظام من الصفر.